

1. 서 론
2. 주요 태양광발전소 핵심 성능지표(Key Performance Index, KPI) 및 데이터 표준
2.1 기술적 태양광발전소 핵심 성능지표
2.2 태양광발전 모니터링 데이터 표준
3. 태양광발전소 모니터링 데이터 성능지표 분석
3.1 분석 자료 개요
3.2 이용률 및 성능계수 분석
4. KPI 기반의 이상감지 인공지능 모델 평가
5. 결 론
기호 및 약어 설명
: 성능계수
: 온도보정 성능계수
: 발전된 에너지(kWh)
: 설비 정격용량(kW)
: 경사면 일사량(kWh/m2)
: 기준 일사량(1kW/m2)
: 모듈 온도(℃)
: 기준 온도(25℃)
: 기간(시간, hour)
: 운전 시간
: 고장시간
1. 서 론
최근 태양광발전 설비의 보급 확대와 함께 운영 데이터가 지속적으로 축적되면서, 발전소의 성능을 평가하는 수준을 넘어 인공지능 기반의 이상진단 및 예측 유지보수 기술에 활용하려는 연구가 활발히 진행되고 있다1,2). 기존의 인공지능 기반 고장진단 연구는 모듈의 I-V 곡선, 열화상 영상, 드론 영상, 스트링 전류 및 인버터 운전 데이터 등을 입력 변수로 활용하여 다양한 고장 유형을 분류하는 데 주로 초점을 맞추고 있다3). 그러나 이러한 방법은 별도의 계측 장비와 대용량 데이터 저장 환경이 요구되므로, 현장 적용 시 데이터 획득 비용과 시스템 구축 비용이 증가하는 한계를 가진다. 반면, 태양광발전소의 운영 과정에서 일상적으로 생성되는 성능비(Performance Ratio, PR), 이용률(Capacity Factor, CF), 가동률(Availability) 등의 핵심 성과지표(Key Performance Indicators, KPIs)는 대부분의 모니터링 시스템에서 별도의 추가 계측 없이 산출할 수 있으며, 발전소의 운영 상태를 종합적으로 반영하는 대표적인 성능지표로 활용되고 있다4,5). 특히 PR과 CF는 발전 성능 저하와 운영 효율 변화를 장기적으로 평가할 수 있어 발전소의 성능평가뿐만 아니라 이상 상태를 식별하기 위한 입력 변수로 활용될 가능성이 높다. 그러나 현재까지의 연구는 KPI의 산출 정확도 향상이나 표준화 기법에 주로 초점을 맞추고 있으며6,7), 산출된 KPI를 활용하여 발전소의 운전 상태를 자동으로 진단하는 비지도학습 기반 인공지능 모델에 대한 연구는 상대적으로 부족한 실정이다. 또한 실제 태양광발전소에서는 경제성과 통신 효율을 고려하여 일반적으로 5 ~ 10분 간격의 모니터링 데이터를 수집하고 있으나, 이러한 데이터로부터 생성된 일 단위 KPI를 활용하여 발전소의 운전 패턴을 분석하고 이상 상태를 식별하는 연구는 제한적으로 이루어지고 있다8). PR과 CF는 발전소의 운영 특성을 서로 다른 관점에서 반영한다. PR은 일사량 대비 발전 성능을 나타내므로 출력 저하에 민감하지만 일사량 센서의 계측 오차에도 영향을 받을 수 있다. 반면 CF는 장기적인 발전 성능을 안정적으로 평가할 수 있으나 이상 상태에 대한 민감도는 상대적으로 낮다. 따라서 두 성능지표를 함께 활용할 경우 발전 성능 저하와 계측 이상을 효과적으로 구분할 수 있을 것으로 기대된다. 이에 본 연구에서는 약 4년 5개월간 운영된 88.2 kWp 태양광발전소의 10분 간격 모니터링 데이터를 이용하여 일 단위 이용률과 온도보정 성능비를 산출하고, 이를 입력 변수로 Isolation Forest (i-Forest), k-means 및 Gaussian Mixture Model (GMM)을 적용하여 비지도학습 기반 이상진단의 적용 가능성을 분석하였다. 또한 각 KPI의 특성과 비지도학습 모델의 군집 특성을 비교·분석하여 정상 운전, 발전 성능 저하, 저일사량 운전 및 계측 이상에 따른 운전 패턴의 구분 가능성을 평가하였다. 이를 통해 기존 태양광발전소에서 일반적으로 수집되는 10분 간격 모니터링 데이터만으로도 별도의 고장 라벨이나 추가 계측 장비 없이 운전 이상 패턴을 식별할 수 있는 경제적이고 실용적인 인공지능 기반 운영·유지관리 기술의 적용 가능성을 제시하고자 한다.
2. 주요 태양광발전소 핵심 성능지표(Key Performance Index, KPI) 및 데이터 표준
2.1 기술적 태양광발전소 핵심 성능지표
태양광 시스템의 평가는 단순 발전량의 비교만으론 충분치 않고, 일사 조건, 온도, 설비 상태, 운영 방식, 유지보수 수준 등을 종합적으로 고려할 수 있는 정량적 지표가 필요하다. 태양광발전소의 실제 운전 성능을 체계적으로 진단하고, 기대 성능과의 차이를 분석하며, 장기적인 신뢰성과 운영 효율을 평가하기 위한 핵심 도구로 활용이 된다. 이런 기술 핵심 성능지표는 설계단계의 예상 성능, 운영 단계의 이상 탐지, 유지보수 성과 평가, 장기 열화 분석까지 폭넓게 적용되므로, 태양광 시스템의 성능을 분석하는 데 필수적인 요소라고 할 수 있다.
기술 KPI 중 가장 대표적 지표의 첫 번째는 성능계수(Performance Ratio, 이하 PR)이다. PR은 주어진 일사 조건에서 태양광 시스템이 실제로 얼마나 효율적으로 전력을 생산했는지 나타내는 지표이고, 태양광발전소의 운영 성능을 평가하는 데 널리 사용된다. 그러나, PR은 모듈 온도의 계절적 변화에 민감하므로 단순 수치를 비교하는 것은 주의가 필요하며, 실질적으로는 온도영향을 보정한 PR을 주로 사용하게 된다. 직류/교류의 비가 큰 과대 설계 시스템에서는 인버터 클리핑으로 인해 고 일사 조건에서 PR이 감소할 수 있어, PR은 설계 조건과 운전 환경을 고려해 해석되어야 한다. PR 계산식은 식(1)과 같다. 온도보정 PR은 식(2)과 같이 나타낼 수 있다.
두 번째는 지표는 이용률(CF)이며, 이용률은 시스템이 실제로 발전 가능한 상태에 있었던 비율을 의미하며, O&M 계약 및 성능보증 계약에서도 중요한 판단 기준으로 활용된다. 그러나, 이용률은 단순한 가동시간 비율이 아니라, 어떠한 정지시간을 시스템 책임 범위에 포함할 것인지에 따라 결과가 크게 달라지는 특성이 있다. 예를 들어 전력 계통 고장, 외부 전원 차단, 출력제한 등의 원인을 제외할지에 따른 시스템 이용률이 달라질 수 있다. 이용률 계산식은 식(3)과 같다.
추가적인 지표로는 가동률(Availability)이 있는데, 가동률은 발전설비가 발전할 수 있는 상태로 유지된 시간의 비율을 나타내는데, 식(4)과 같이 정의된다.
이용률과의 지표 차이는 이용률이 발전량을 나타낸다면 가동률은 운전된 시간을 나타내는 것이다.
오염 손실과 장기 성능 저하를 평가하는 지표로는 오염계수(Soiling Ratio), 열화율(Degradation Rate), 성능손실률(Performance Loss Rate)이 있다9). 오염계수는 오염 센서로부터 측정된 값의 분석을 통해 산출되고, 열화율은 장기간 운전 데이터를 기반으로 성능비(PR) 및 단위 발전량과 같은 정규화된 성능지표의 추세 분석을 통해 유추할 수 있다. 특히, 온도보정 및 일사량 변동, 오염 등의 외란 요인을 제거함으로써 순수한 성능 저하 경향을 분리할 수 있다. 일반적으로 수년 이상의 시계열 데이터를 활용하여 선형 회귀 또는 강건 통계 기계학습 모델을 적용함으로써 연간 열화율(%/year)을 산정이 가능하다. 또한, I–V 곡선으로부터 도출되는 개방전압, 단락전류, 충진률 등의 전기적 파라미터는 모듈의 물리적 열화 메커니즘을 해석하는 데 중요한 료가 된다.
2.2 태양광발전 모니터링 데이터 표준
태양광발전 시스템의 성능을 분석하기 위해서 디지털화된 모니터링 데이터가 사용된다. KS C IEC 61724-1:2017에 따르면 태양광 시스템에 대한 모니터링 요구사항이 규정되어 있다. 데이터 샘플링, 기록에 대한 사항은 6절에 기술되어 있다. 규정에서 요구되는 샘플링 및 기록간격 요구사항은 Table 1과 같다. 변동성이 심한 데이터의 고정밀 등급의 데이터는 샘플링 간격은 3초, 기록은 1분으로 정하고 있고, 중간 정밀도 데이터 세트는 샘플링 1분 이내 및 기록도 1분 이내로 정하고 있다. 그러나, 전력 데이터나 일사량 데이터와 같이 변동이 빈번한 데이터는 가능한 샘플링 간격을 작게 하여 수집하면 데이터 분석 정확도를 상승시킬 수 있다.
Table 1
Sampling and Recording Interval Requirements Specified in KS C IEC 61724-1
국내 공공기관에서 운영·관제 중인 태양광발전소의 데이터는 Table 1과 같이 저장주기는 Class A 기준인 1분 간격을 적용하고 있으나, 실제 데이터 수집은 순시 1분 값 기반으로 수행되어 Class B 수준의 샘플링 방식을 활용하고 있다. 이에 따라 대부분의 수집 데이터는 실질적으로 Class B 수준의 데이터 품질 특성을 가진다.
3. 태양광발전소 모니터링 데이터 성능지표 분석
3.1 분석 자료 개요
본 절에서는 태양광발전소 모니터링 데이터를 이용해 이용률과 성능계수에 대해 분석을 하였다. Fig. 1은 태양광발전소의 인버터 및 환경센 서로부터 모니터링하고 있는 10분 순시 데이터 항목과 데이터값이다. Table 2는 태양광발전소의 정보이다. 해당 데이터는 인버터와 기상 센서로부터 RTU 장치를 통해 수집된다. 본 연구에서는 관제 플랫폼으로부터 수집된 데이터를 이용한 이용률과 성능계수에 대한 분석을 시행하였다. 이에 따라 센서의 오염이나 데이터 수집 시간 미동기로 발생하는 문제는 없을 것이라 가정하고 분석을 하였다. 데이터는 누적 에너지량을 이용한 이용률 분석과 일사량이 500 W/m2 이상의 데이터를 추출해 분석한 일 단위 PR 분석을 하였다. 데이터 수집 기간은 2022년 1월 18일부터 2026년 6월 1일까지이며, 약 4년 5개월이다.
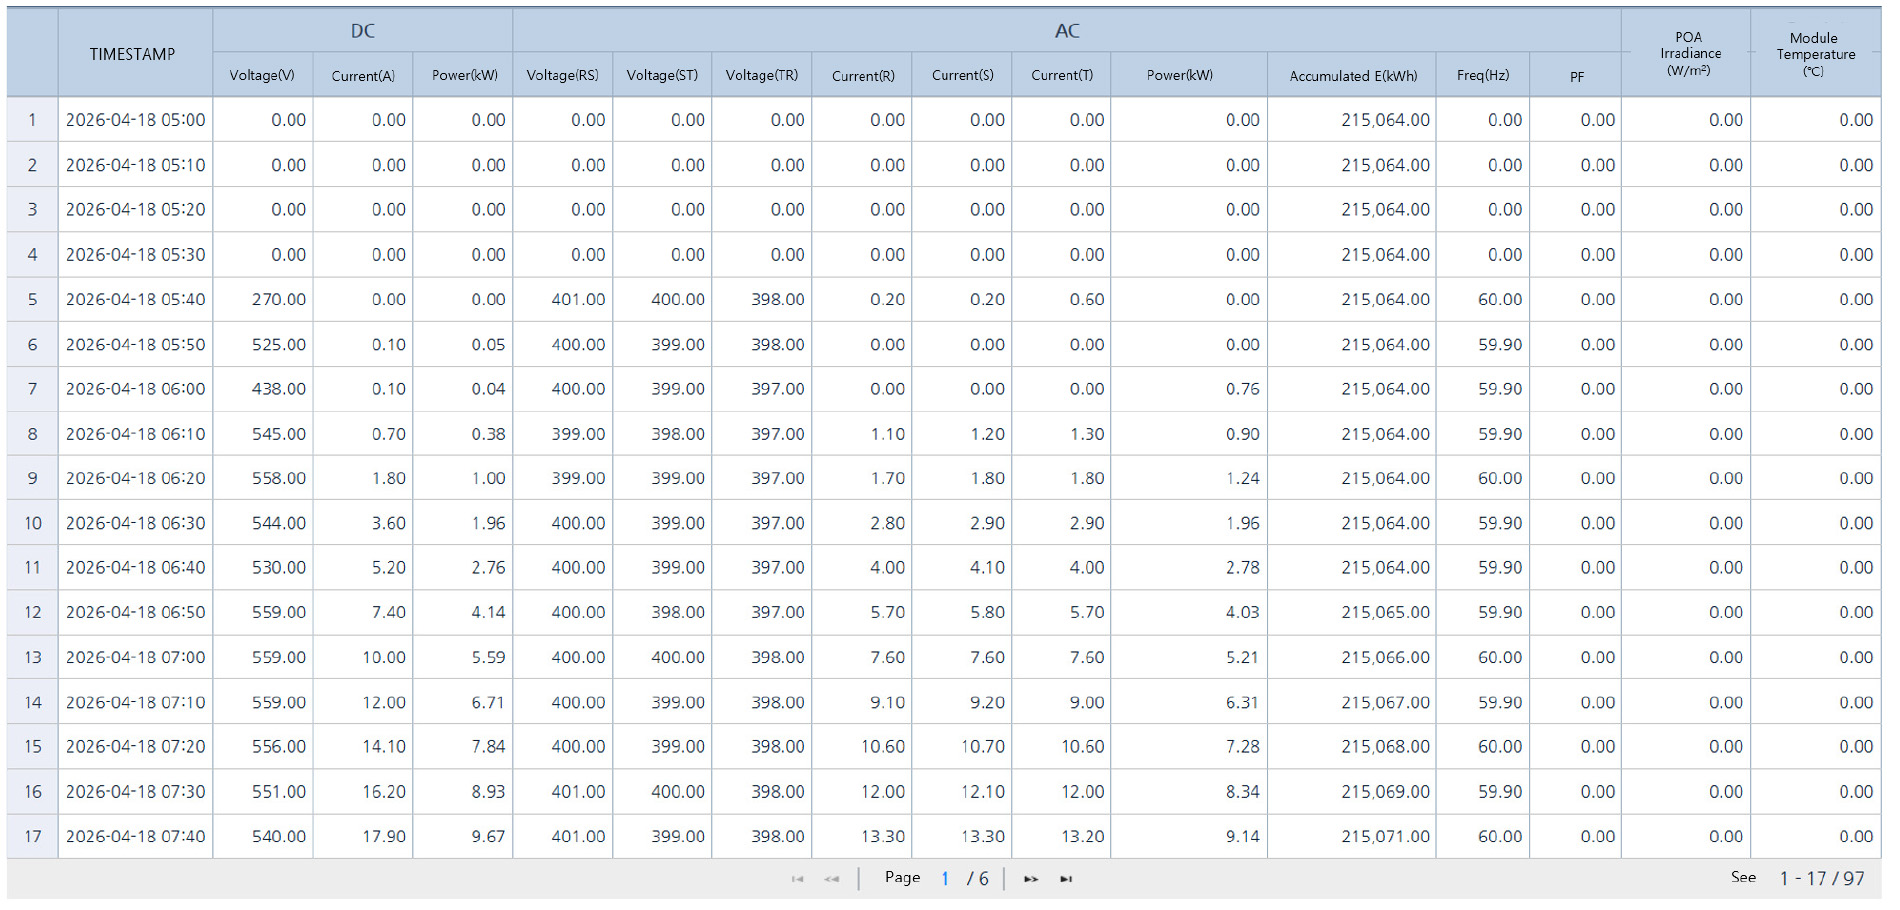
Table 2
PV Plants Data Information
| PV plants |
Total Rated Power (kWp) |
Capacity of Inverter (kW) |
Number of PV module (EA) |
Commercial Operation Year |
| Site A | 88.2 | 100(1Set) | 196(450W/module) | 2022.01 |
3.2 이용률 및 성능계수 분석
본 연구에서는 이용률 분석을 위해 인버터 누적 에너지량을 이용해 분석을 실시하였다. PR 같은 경우에는일사량이 500 W/m2 이상 데이터만 추출해 분석했다. 일사량이 낮은 구간에서는 PR 값이 100% 이상 나오는 경우가 다수 발생하게 된다. Fig. 2는 일사량이 500 W/m2 이상인 데이터를 선별하여 AC 출력과 일사량의 시계열 변화를 나타낸 것이다. 2025년 이후 일부 구간에서 일사량이 1,700 W/m2 이상으로 비정상적으로 높은 값이 측정되었으나, 동일 시점의 AC 출력에서는 이에 상응하는 출력 증가나 유의한 변동이 관찰되지 않았다. 이러한 일사량과 AC 출력 간의 불일치는 실제 일사 조건의 변화라기보다는 일사량이 과대 계측된 결과일 가능성이 높은 것으로 판단된다. 따라서 2025년 이후 관측된 비정상적인 고일사량 값은 일사 센서의 성능 저하 또는 계측 이상에 기인했을 가능성이 있는 것으로 판단된다.
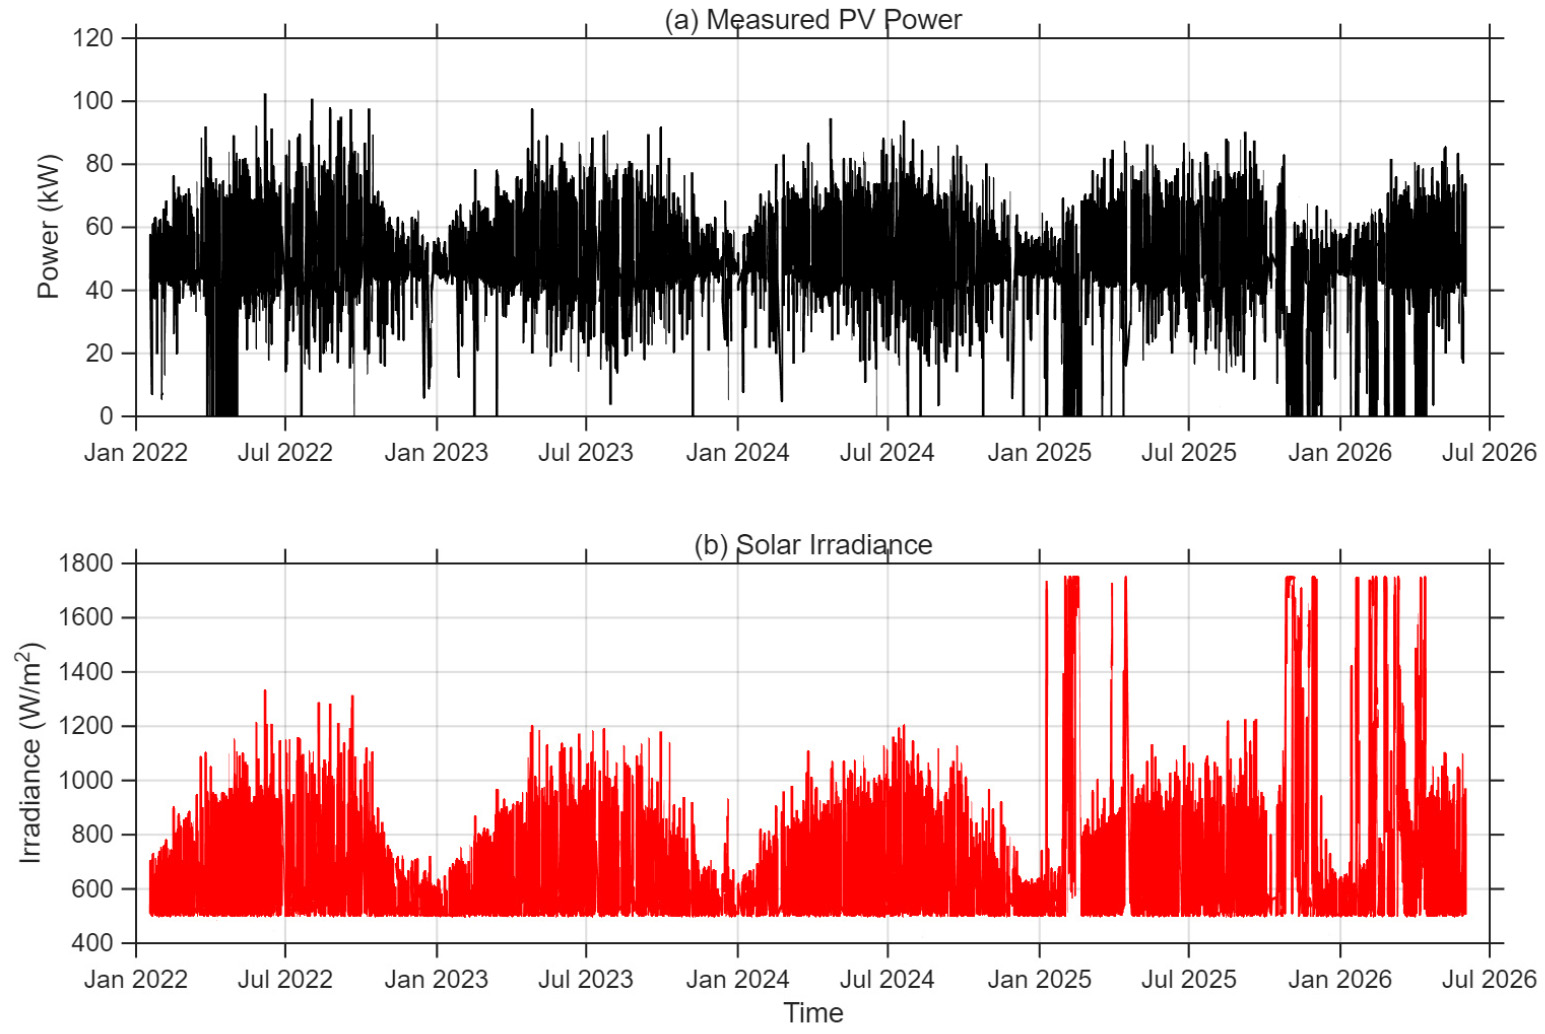
Fig. 3은 Site A의 월별 이용률(Capacity Factor) 분석 결과를 나타낸다. 이용률은 계절적 특성에 따라 매년 4 ~ 5월에 가장 높은 값을 보였으며, 일사량이 감소하는 겨울철(12 ~ 2월)에는 전반적으로 낮은 수준을 나타냈다. 장기 운전 특성을 살펴보면, 초기 운전 시기와 비교하여 이용률이 다소 감소하는 경향이 관찰되지만, 약 4년간의 운영 기간 동안 급격한 성능 저하 없이 비교적 안정적인 운전 상태를 유지한 것으로 판단된다. 그러나 이용률은 발전소의 장기적인 운영 성능을 평가하는 데는 유용한 지표인 반면, 계절 변화와 기상 조건의 영향을 크게 받기 때문에 특정 고장이나 이상 상태를 직접적으로 식별하기에는 한계가 있다.
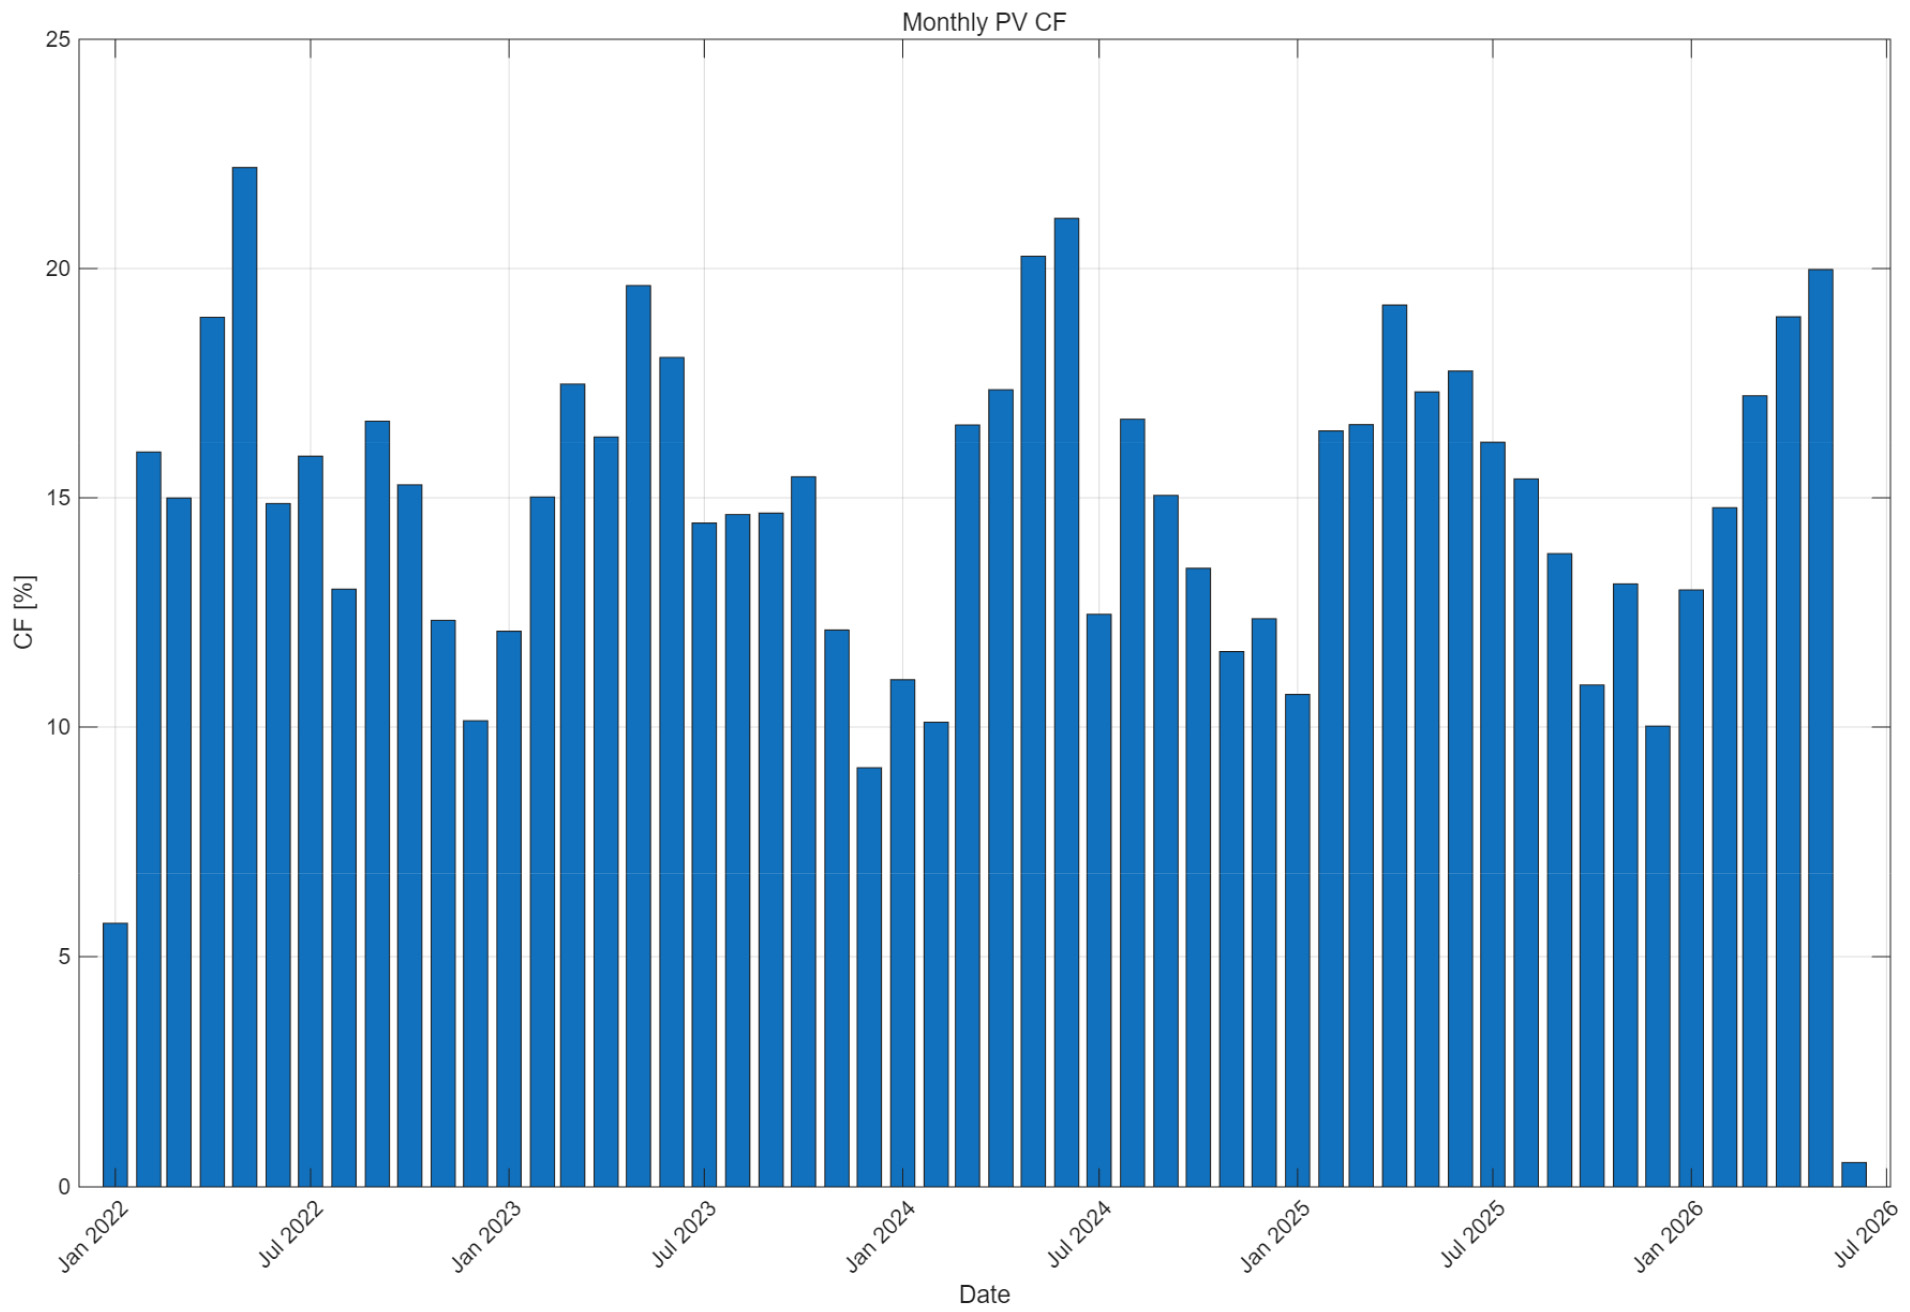
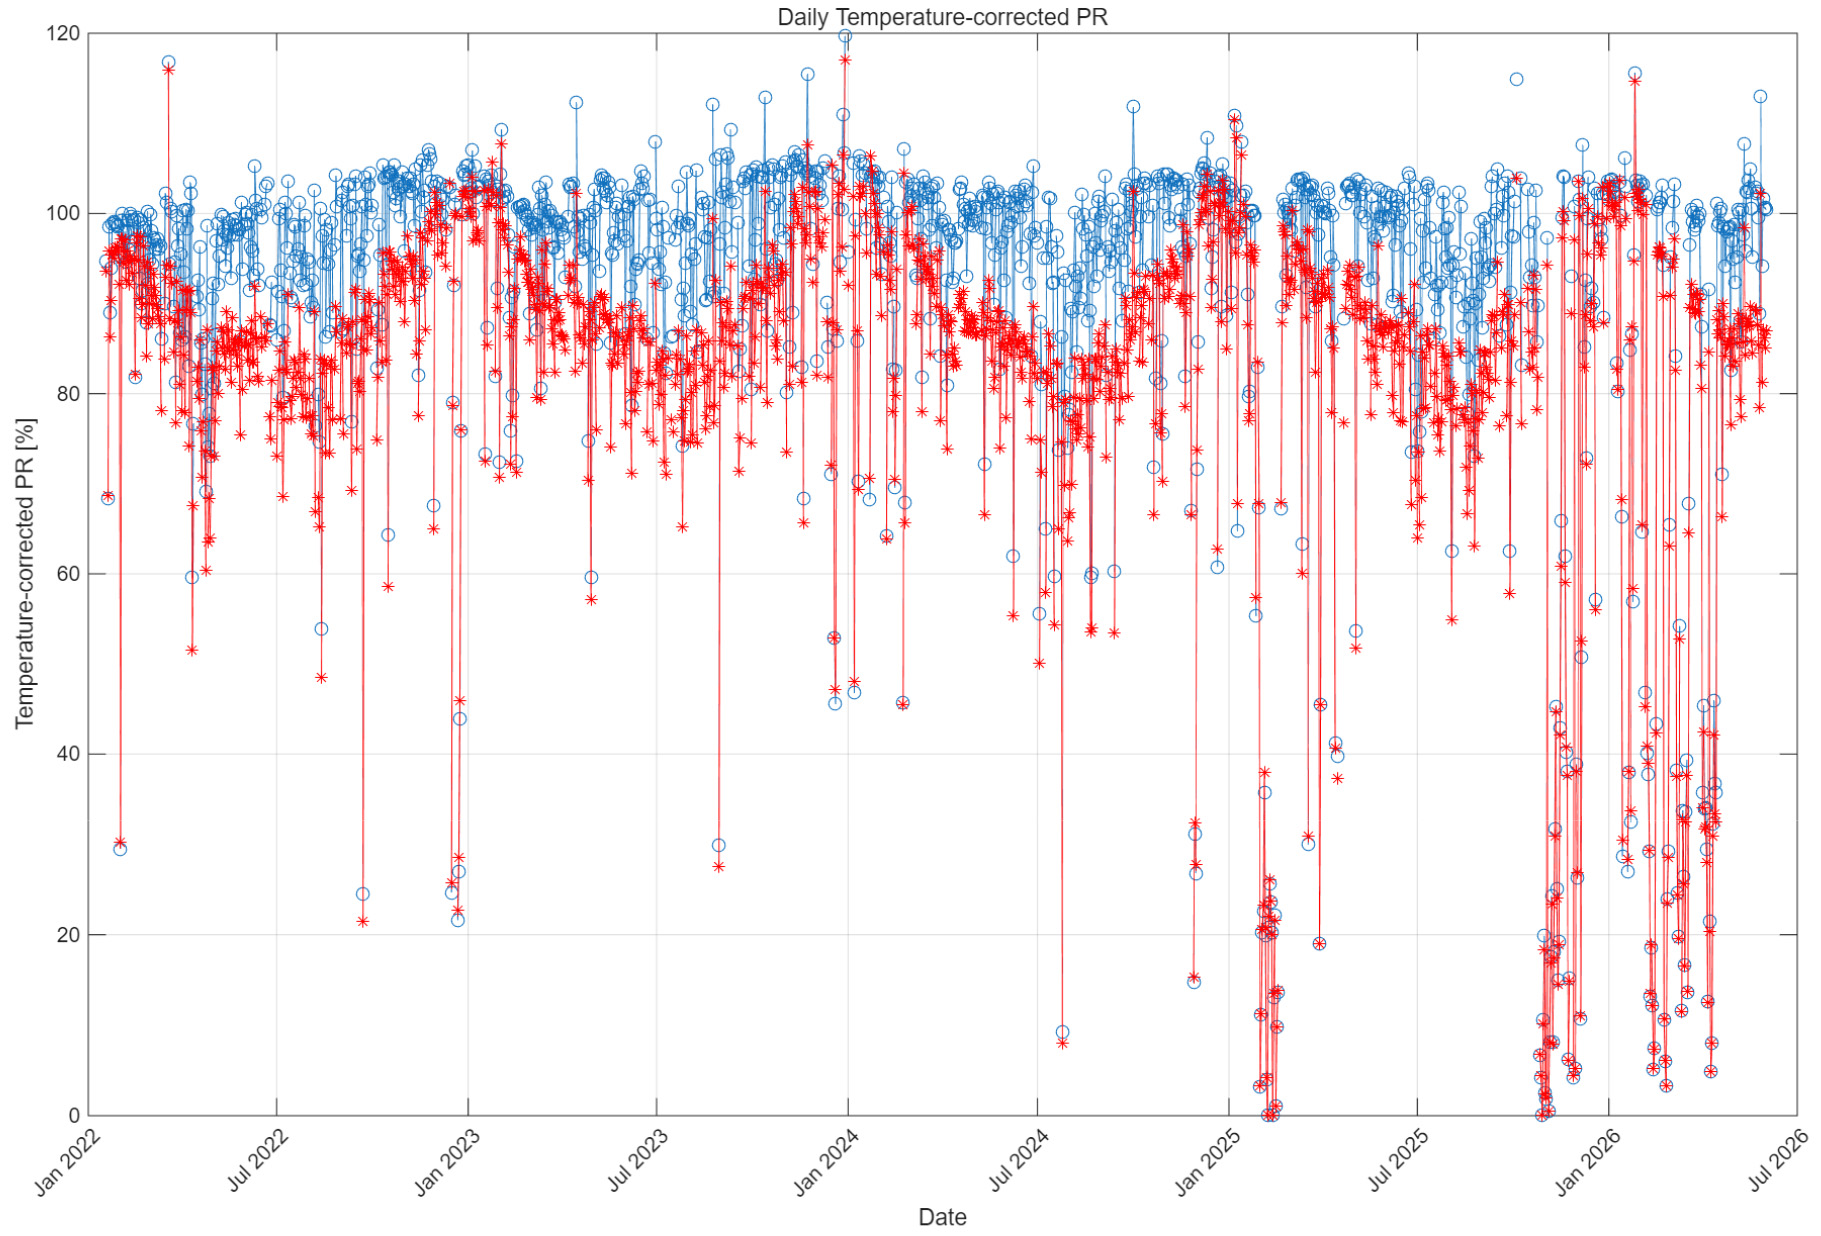
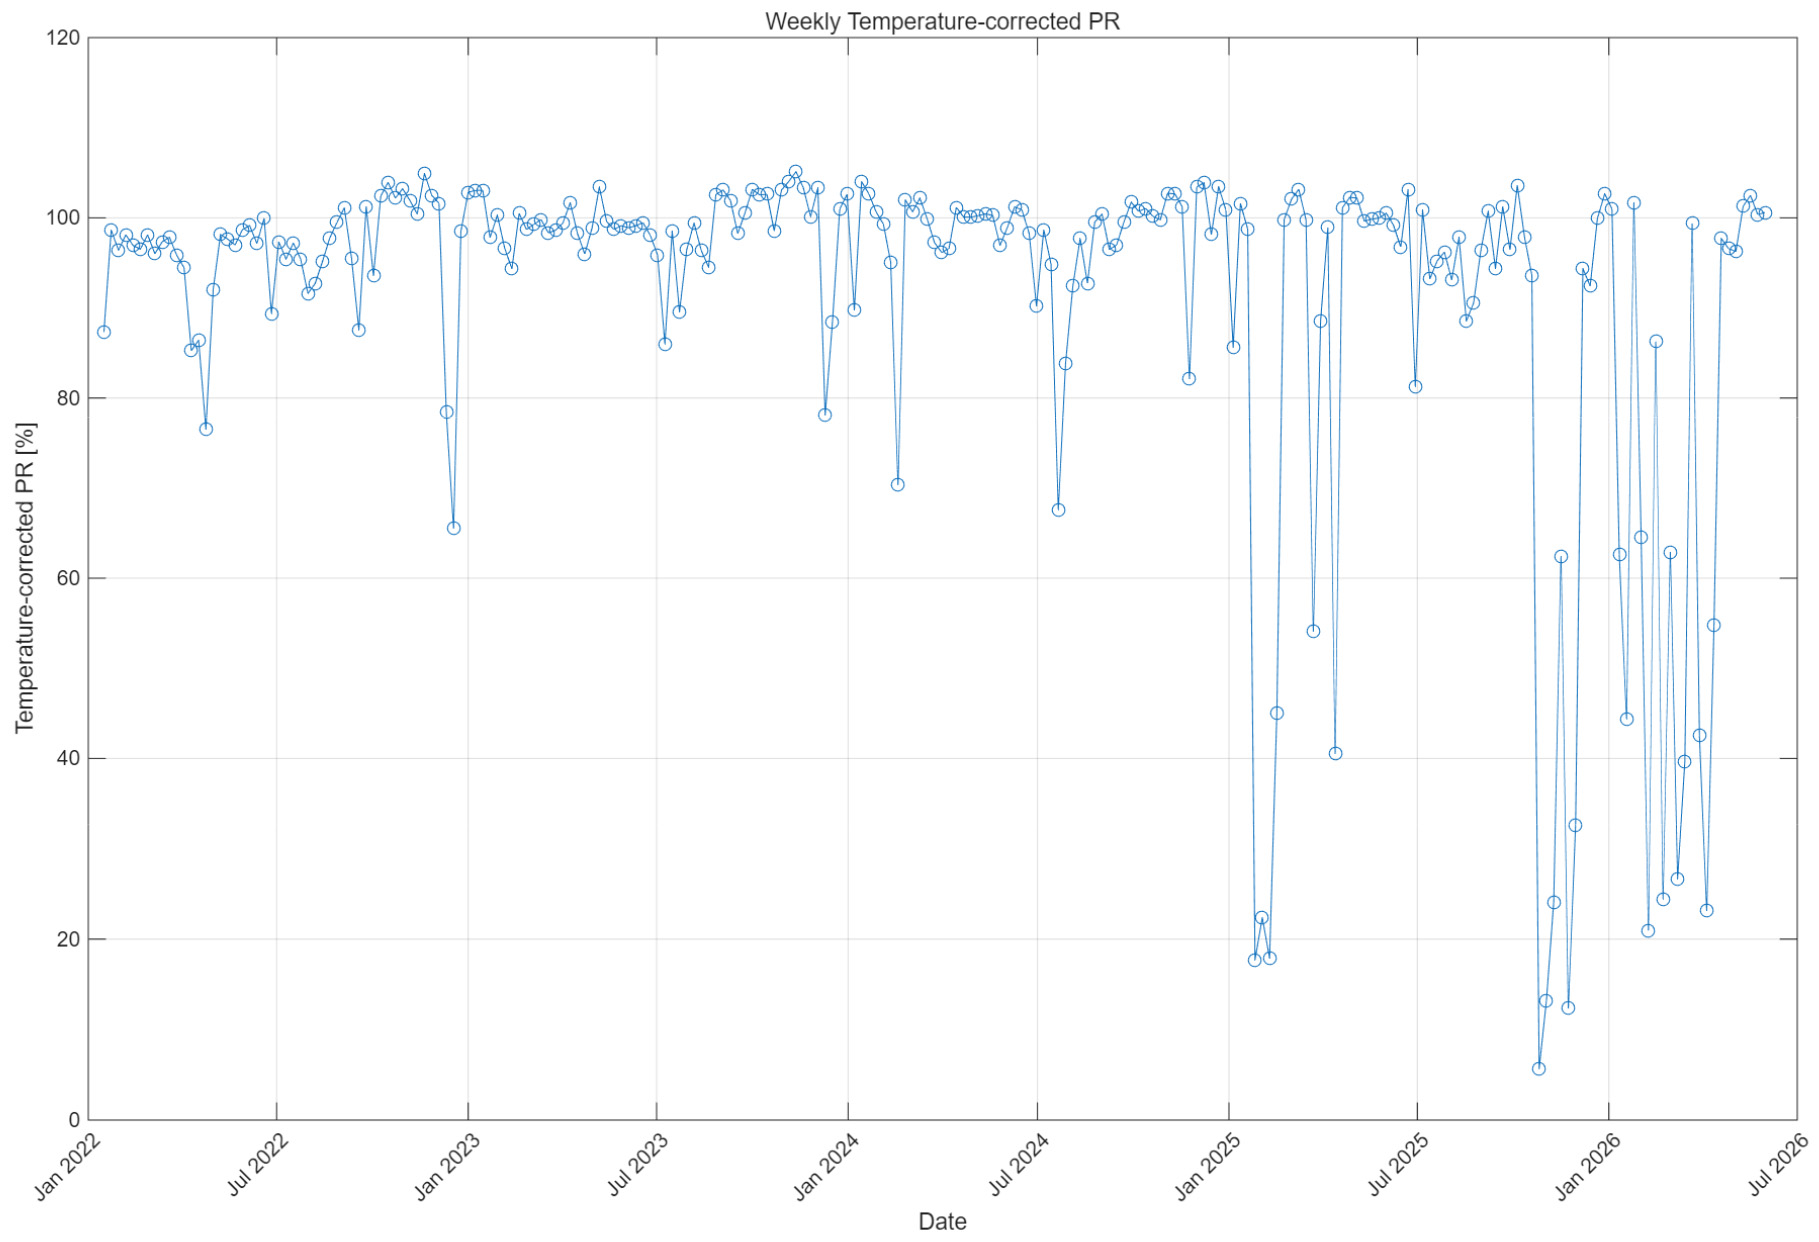
Fig. 4는 Site A의 일별 온도 미보정 PR과 온도 보정 PR의 분석 결과를 나타낸다. 본 분석은 일사량이 500 W/m2 이상인 데이터를 대상으로 수행하였다. 일반적으로 온도 보정 PR은 온도 영향을 보정함으로써 미보정 PR보다 다소 높은 값을 나타낼 수 있으나, 일부 구간에서는 100%를 초과하는 값이 관찰되었다. 이는 실제 발전 성능 향상이라기보다 일사량 계측 오차, 센서 보정 상태, 데이터 동기화 오류 등으로 인해 입력 데이터가 과대 산정되었을 가능성을 시사한다. 또한 일별 PR 분석 결과에서는 일부 기간에 PR이 70% 이하로 저하되는 구간이 반복적으로 나타났으며, 특히 2025년 이후에는 일부 데이터가 10% 이하까지 감소하는 현상이 확인되었다. Fig. 5는 Site A의 주간 평균 PR 분석 결과를 나타낸다. 분석 결과, 2025년 1월 이후 PR이 이전 기간에 비해 급격히 감소하는 경향이 확인되었다. 반면 동일 기간의 이용률은 큰 변화 없이 비교적 안정적인 수준을 유지하였다. 일반적으로 발전설비의 성능이 실제로 저하되었다면 PR과 이용률이 동시에 감소하는 경향을 보이는 것이 일반적이다. 그러나 본 사례에서는 이용률의 변화가 크지 않은 반면 PR만 현저히 감소하였으므로, 설비 성능 저하보다는 일사량 센서의 이상, 계측 오차 또는 데이터 수집 과정에서의 오류로 인해 일사량이 실제보다 높게 계측되었을 가능성이 높은 것으로 판단된다. 이러한 결과는 PR이 발전설비의 이상 상태뿐만 아니라 입력 데이터의 품질에도 매우 민감하게 반응하는 성능지표임을 보여주며, 성능평가 및 인공지능 기반 이상진단에 활용하기 위해서는 데이터 품질 관리가 매우 중요하다는 것을 확인할 수 있다. 장기 데이터 기반 PR 값을 분석하는 데 있어 일 단위 보다는 주 또는 월 단위의 분석이 고장을 인지하기에 유요한 것을 알 수 있다.
4. KPI 기반의 이상감지 인공지능 모델 평가
KPI 요소는 데이터 기반 태양광발전소 성능이나 고장 상태를 파악하기에 매우 효과적인 요소라는 것을 확인하였다. 태양광 발전소의 핵심 성과지표(KPI)인 이용률(Capacity Factor)과 성능비(Performance Ratio, PR)를 입력 변수로 활용하는 비지도 학습기반의 머신러닝모델을 생성하여 분석을 실시하였다. 두 지표는 각각 발전량과 시스템 성능을 서로 다른 관점에서 반영하므로, 이를 함께 활용할 경우 단일 지표로는 확인하기 어려운 성능 이상 패턴을 효과적으로 식별할 수 있을 것으로 판단하였다.
이상 패턴 분석은 실제 태양광 발전소 운영 환경을 고려하여 비지도학습 기반으로 수행하였다. 발전소 운영 데이터는 정상 데이터의 비중이 높고 이상 데이터는 상대적으로 적으며, 고장 발생 시점과 원인이 명확하게 라벨링되지 않은 경우가 많다. 이러한 특성으로 인해 지도학습 기반 모델의 적용에는 한계가 있으므로, 본 연구에서는 데이터의 분포 특성을 기반으로 이상 패턴을 탐지할 수 있는 비지도학습 알고리즘을 적용하였다. 입력데이터는 일 단위 이용률(CF)과 온도보정 성능비(PR)로 구성하였다. KPI 산출 과정에서 결측값(NaN) 및 계산 과정에서 발생한 Inf 데이터는 분석에서 제외하였으며, 모델 입력 전 Min-Max 정규화를 수행하였다. PR은 일사량 500 W/m2 이상 조건에서 산출하였으며, 최종적으로 정상 운전일과 이상 운전일을 포함한 총 1,350개의 일 단위 데이터를 비지도학습 모델의 입력으로 사용하였다. 모델 학습 전 두 성능지표의 스케일 차이를 최소화하기 위해 데이터를 정규화하였으며, 이후 정규화된 KPI 데이터를 대상으로 Isolation Forest (i-Forest), k-means, Gaussian Mixture Model (GMM)을 각각 적용하여 성능 이상 패턴 탐지 결과를 비교하였다10,11,12). i-Forest는 데이터가 정상 분포로부터 얼마나 쉽게 고립되는지를 기준으로 이상 여부를 판단하는 알고리즘으로, 정상 군집에서 벗어난 소수의 이상 데이터를 효과적으로 탐지할 수 있다는 장점이 있다. i-Foreat 모델은 100개의 isolation Tree를 사용하였고, contamination Fraction은 0.05로 설정하였다. 이상여부는 학습과정에서 산정된 score threshold = 0.6305를 기준으로 판정한다. 본 연구에 사용된 비지도 학습 모델의 파라메터 값은 Table 3과 같다.
Table 3
Parameters of Unsupervised Learning Models
| Model | Parameter | Value |
| Isolation Forest | Num Learners | 100 |
| Contamination Fraction | 0.05 | |
| Score Threshold | 0.351 | |
| k-means | Clusters | 4 |
| Replicates | 50 | |
| GMM | Components | 4 |
| Covariance type | FULL | |
| Replicates | 50 |
i-Forest 모델은 이용률과 PR의 분포에서 정상 운전 영역으로부터 이탈한 데이터를 이상 후보로 식별하는 데 활용된다. Fig. 6은 i-Forest 모델을 이용한 이상 탐지 모델의 결과를 나타낸다. 이용률이 약 15%이나 PR이 60% 이하 낮은 상태임에도 이상으로 판단하지 않고, 정상으로 판단한 잘못된 결과가 도출되었다.
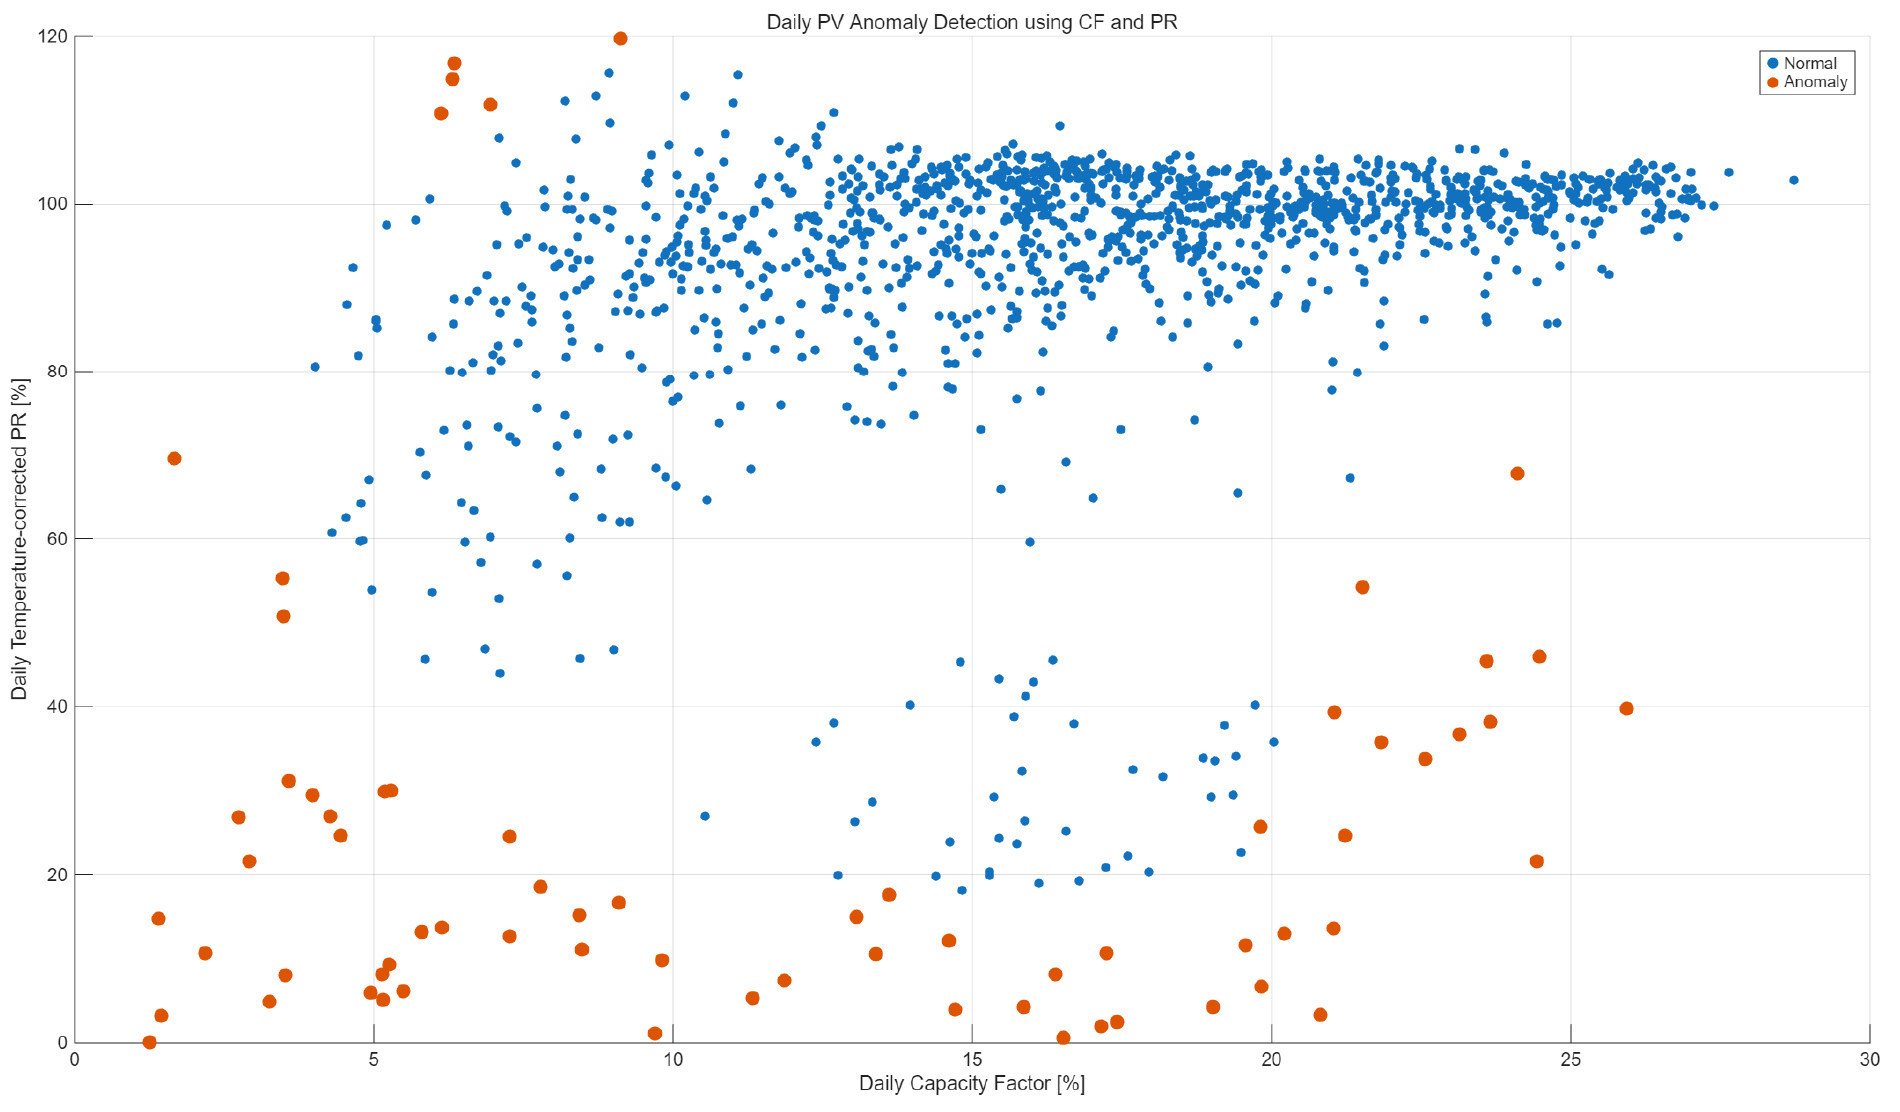
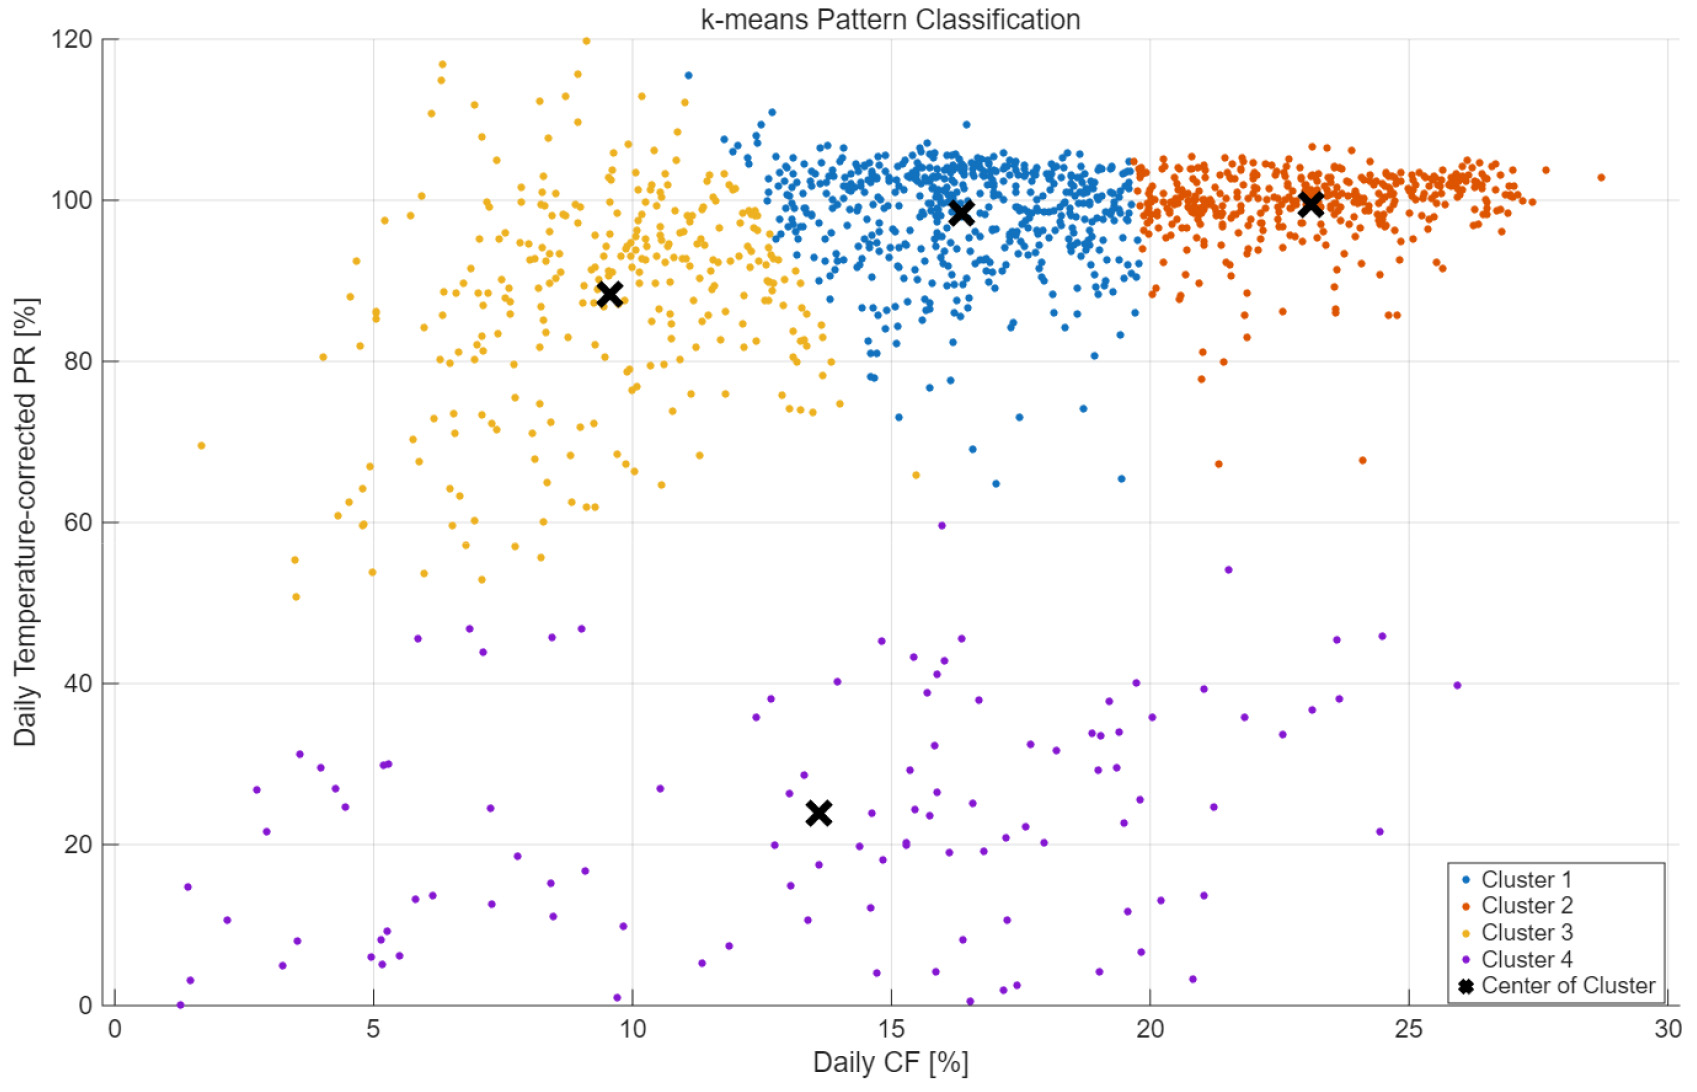
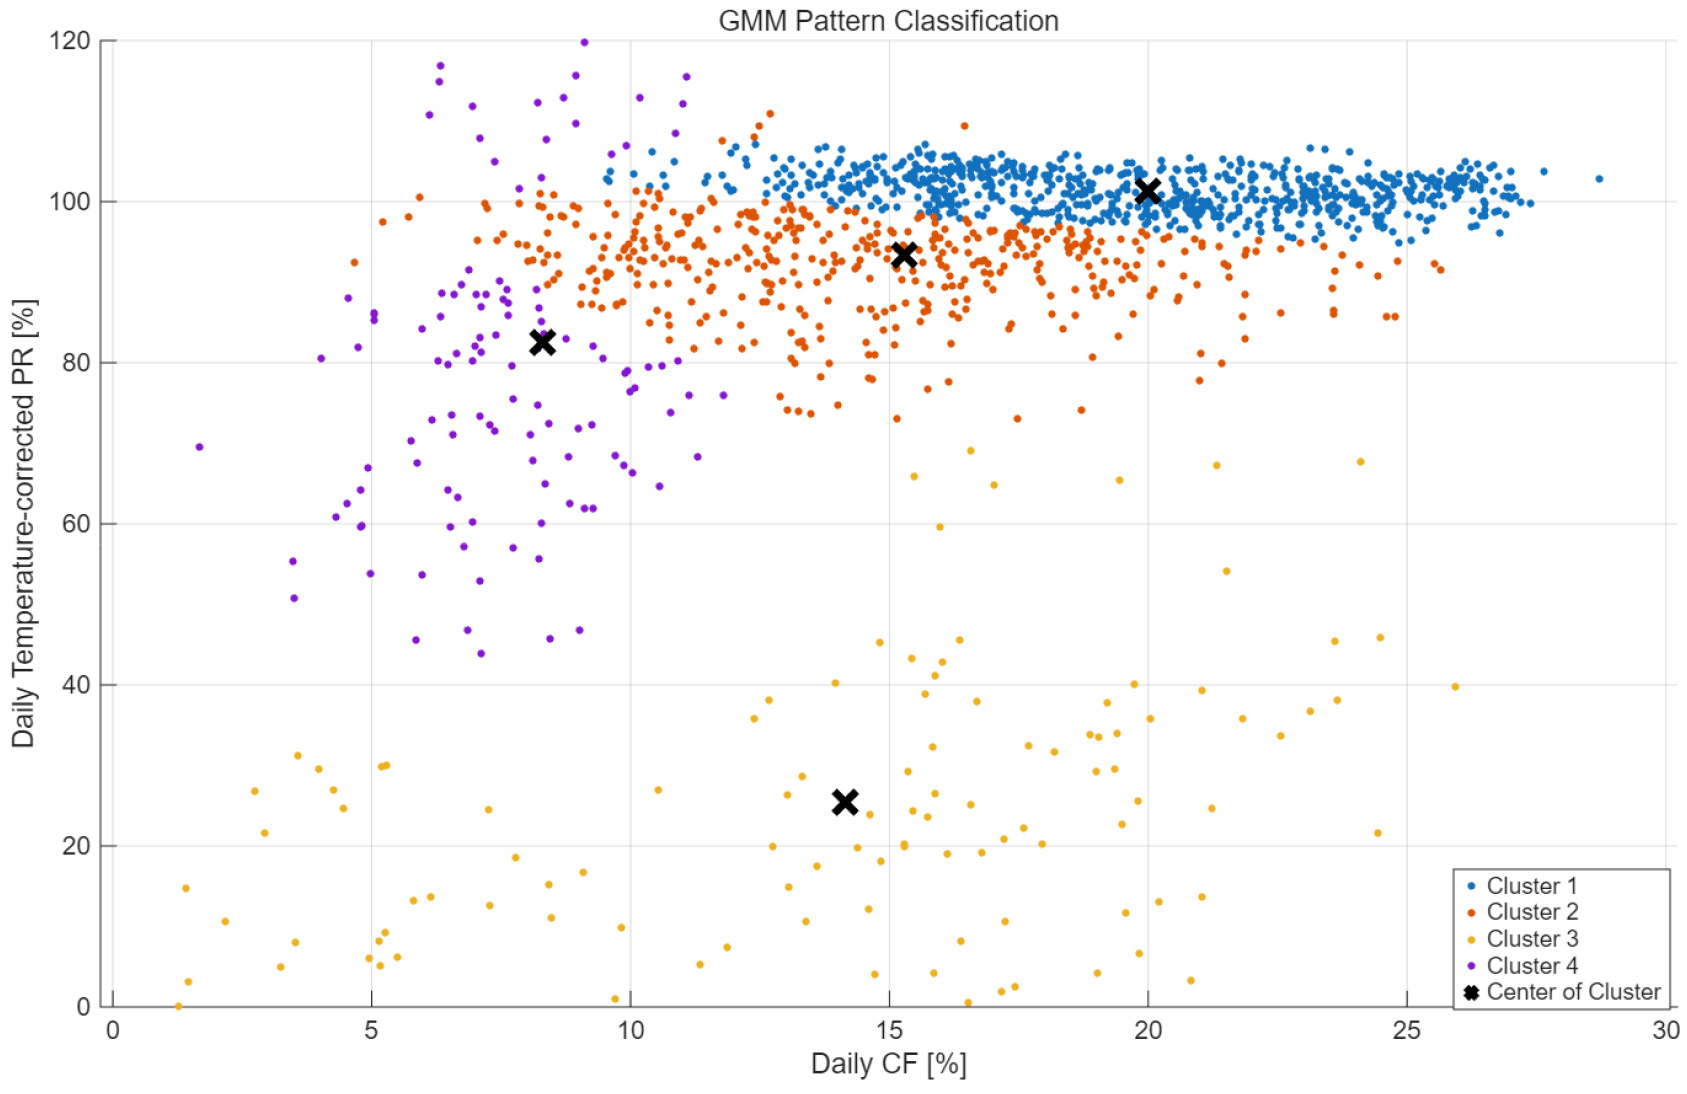
Fig. 7은 이상에 대한 시계열 점수를 나타내는데, 25년 1월 이후부터 다수의 이상이 발생되고 있는 것으로 분석되었다. k-means 모델은 데이터 간의 유사성을 기준으로 전체 데이터를 k개의 군집으로 분할하는 대표적인 군집화 알고리즘이며, GMM 모델은 데이터가 여러 개의 가우시안 분포의 조합으로 구성된다고 가정하는 확률 기반 군집화 모델이다. k-means 모델은 이상 탐지 알고리즘이 아니라 군집화 알고리즘으로 데이터에서 n개의 군집으로 분류하는데 유용한 모델이라고 할 수 있다. GMM의 군집 수는 Bayesian Information Criterion (BIC)을 이용하여 결정하였다. 군집 수를 2 ~ 6까지 변화시키며 BIC를 계산한 결과 4개의 Gaussian component에서 최소 값을 나타내어 최종 군집 수를 4로 설정하였다. 또한, k-means도 GMM과의 비교를 위해 동일한 군집 수로 적용해 분석했다. Fig. 8과 Fig. 9는 이용률과 온도보정 PR값을 이용해 k-means 모델을 이용해 4개 군집으로 분류한 결과이다. k-means 모델은 이용률에 따른 값의 차이로 군집화가 되었으며, GMM 모델은 PR값의 차이로 군집화가 된 결과가 도출되었다. i-Forest는 정상 데이터 분포에서 벗어난 이상점을 효과적으로 탐지하였으나, 이상 운전 유형을 세부적으로 구분하는 데에는 한계가 있었다. k-means는 CF의 분포를 중심으로 군집을 형성하여 정상 및 일부 운전 상태를 구분할 수 있었지만, PR의 변화 특성을 충분히 반영하지 못하였다. 반면 GMM은 각 군집의 평균과 공분산을 동시에 고려하는 확률 기반 모델로, 정상 운전, 발전 성능 저하, 저일사량 운전 및 일사량 센서 이상을 서로 다른 확률분포로 표현함으로써 운전 패턴을 가장 명확하게 구분하였다. 군집화 모델의 성능을 평가하기 위한 실루엣 계수(Silhouette coefficient)는 자신이 속한 군집에 얼마나 가까운지, 다른 군집과 얼마나 떨어졌는지를 평가하는 계수이다. 실루엣 계수의 의미는 1에 가까울수록 군집이 잘 형성된것이며, 0에 가까운 값은 어느 군집에 속해야 할지 애매하다는 것을 나타낸다. k-means는 0.433, GMM은 0.414로 k-means가 다소 높은 값을 나타냈다. 그러나 Silhouette coefficient는 군집 간 거리와 응집도를 기반으로 군집의 분리 정도를 평가하는 지표로서, 군집이 실제 발전소의 운전 특성이나 이상 상태를 얼마나 적절하게 반영하는지를 직접 평가하는 지표는 아니다. 특히 본 연구에서 사용한 이용률과 성능비는 정상 운전과 이상 운전 데이터가 일부 중첩되는 특성을 가지므로, 군집 간 거리가 명확한 k-means가 상대적으로 높은 Silhouette coefficient를 나타낼 수 있다. 반면 GMM은 각 군집을 확률분포로 모델링하고 평균과 공분산을 동시에 고려하므로, 데이터의 중첩 특성과 비선형 분포를 보다 유연하게 표현할 수 있다. 실제 분석 결과에서도 GMM은 정상 운전, 발전 성능 저하, 저 일사량 운전 및 일사량 센서 이상에 따른 계측 이상을 각각 독립적인 군집으로 구분하여 운전 상태를 물리적으로 해석할 수 있었다. 따라서 본 연구에서는 단순한 군집 분리도보다 운전 패턴의 해석 가능성과 이상 상태의 식별 능력을 고려할 때 GMM이본 연구의 KPI 데이터 특성과 운전 패턴 해석에 보다 적합하였다.
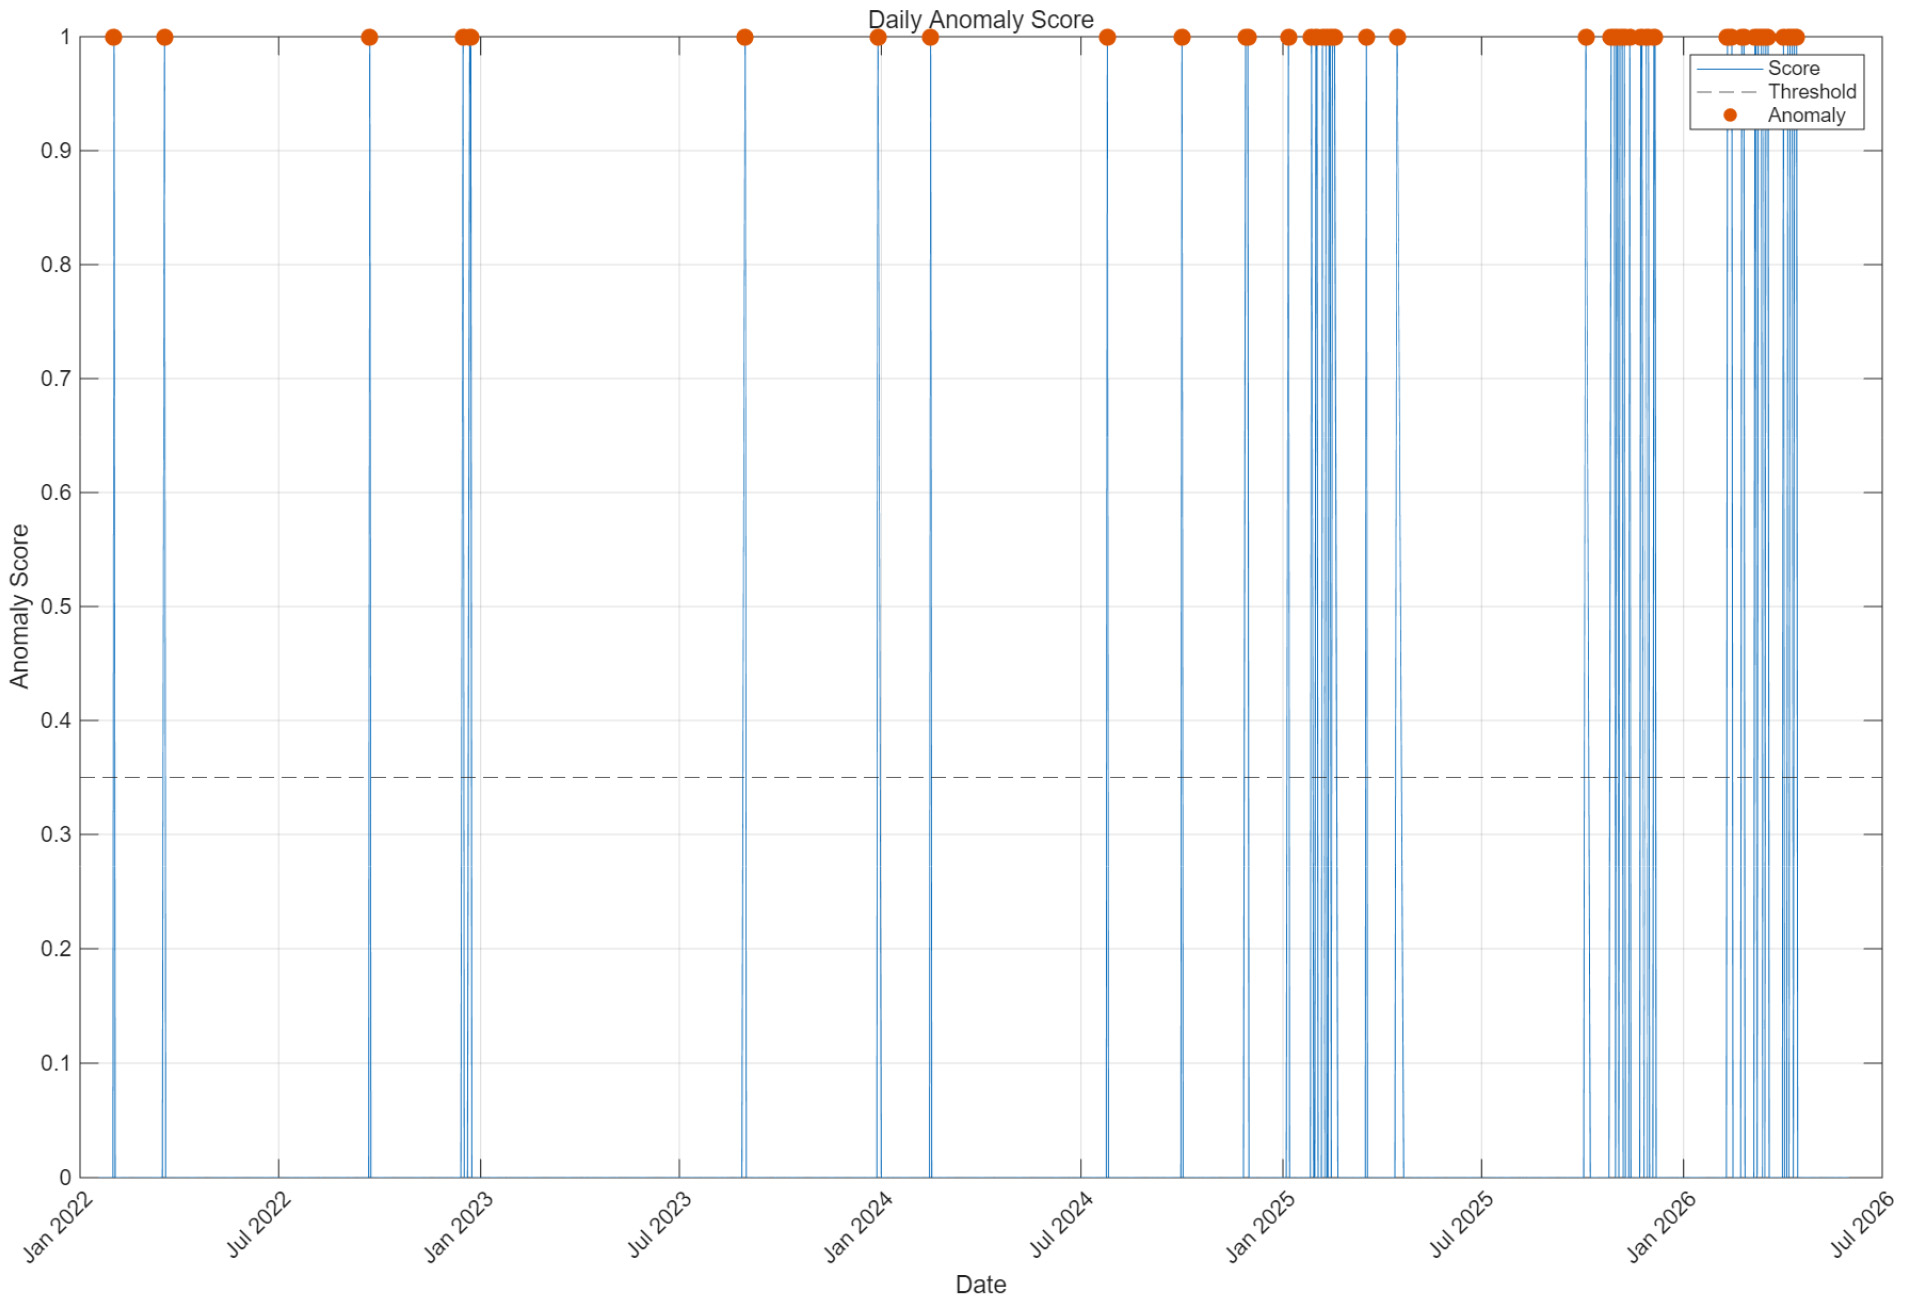
Fig. 8에서 군집 1은 이용률과 PR이 모두 높은 영역에 분포하여 정상 운전 상태를 대표하는 군집으로 판단된다. 군집 2는 이용률은 낮은 구간부터 높은 구간까지 전 범위에 걸쳐 분포하는 반면, PR은 정상 군집에 비해 다소 낮은 수준을 나타냈다. 이는 계절적 요인에 따른 발전 성능 변화와 함께 모듈 오염, 미스매칭 손실 등으로 인해 발전 효율이 일부 저하된 운전 패턴을 반영하는 군집으로 해석된다. 군집 3은 이용률은 낮은 반면 PR은 50% 이상의 범위에 분포하는 특성을 보였다. 이러한 분포는 저일사량 조건으로 인해 발전량이 감소하여 이용률은 낮게 나타나지만, 시스템의 상대적인 발전 성능은 유지된 운전 상태를 반영하는 것으로 판단된다. 반면 군집 4는 이용률은 정상 범위에 분포하는 반면 PR이 현저히 낮은 특성을 나타냈다. 이는 발전설비의 성능 저하보다는 일사량 센서의 계측 오차 또는 기상센서 이상으로 인해 일사량이 실제보다 높게 측정되면서 PR이 과소평가된 결과로 해석된다. 이와 같이 이용률과 PR을 입력 변수로 활용한 GMM 군집화는 정상 운전 상태뿐만 아니라 성능 저하, 저일사량 운전 및 기상센서 이상에 따른 계측 오류 등 서로 다른 운전 특성을 효과적으로 구분할 수 있음을 확인하였다. 특히 성능지표의 분포 특성만으로도 설비 이상과 계측 데이터 이상을 구분할 수 있는 가능성을 제시하였으며, KPI 기반 비지도학습 모델이 태양광 발전소의 운영 상태를 진단하는 효과적인 방법으로 활용될 수 있음을 확인하였다.
이용률과 PR을 함께 활용할 경우 단일 성능지표만으로는 구분하기 어려운 성능 이상 패턴을 효과적으로 식별할 수 있었다. 이용률은 발전소의 장기적인 운영 성능을 반영하지만 기상 조건의 영향을 크게 받으며, PR은 성능 저하에 민감한 반면 일사량 센서 오차나 데이터 동기화 문제에도 영향을 받을 수 있다. 두 지표를 동시에 활용함으로써 발전량 감소에 따른 이상과 입력 데이터 품질 문제를 보다 효과적으로 구분할 수 있었다. 모델별 비교 결과, i-Forest는 정상 운전 영역에서 벗어난 극단적인 이상 데이터를 효과적으로 탐지하였으며, k-means는 KPI 데이터를 정상 운전 특성에 따라 군집화하여 운전 패턴의 변화를 직관적으로 구분할 수 있었다. GMM은 KPI의 확률 분포를 기반으로 다양한 운전 패턴을 효과적으로 모델링하였으며, 정상 군집에 속할 확률이 낮은 데이터를 이상 후보로 식별하는 데 우수한 성능을 나타냈다. 다만 k-means와 GMM은 군집 수 설정에 따라 결과가 달라질 수 있으므로, 데이터 특성에 적합한 모델 파라미터 선정이 중요할 것이다. 이상의 결과는 저해상도 태양광 모니터링 데이터로부터 산출된 이용률과 PR만을 이용하더라도 비지도학습 기반의 성능 이상 패턴 분석이 가능함을 보여준다. 또한 별도의 고장 라벨이나 추가 계측 장비 없이 기존 모니터링 데이터만으로 이상 상태를 탐지할 수 있다는 점에서 경제성과 현장 적용성이 높은 O&M 기술로 활용될 수 있을 것으로 판단된다.
5. 결 론
본 연구에서는 저해상도 태양광 모니터링 데이터로부터 산출된 핵심 성능지표(KPI)를 활용하여 발전소의 성능 특성을 분석하고, 이용률(Capacity Factor)과 성능비(Performance Ratio, PR)를 입력 변수로 하는 비지도학습 기반 이상 패턴 감지 모델의 적용 가능성을 검토하였다. 이를 위해 실제 태양광 발전소의 장기 운영 데이터를 대상으로 월별 이용률, 일별 및 주간 PR을 분석하였으며, 이후 i-Forest, k-means, GMM 모델을 적용하여 KPI 기반 운전 패턴을 비교·평가하였다. 분석 결과, 이용률은 계절적 특성을 비교적 명확하게 반영하였으며, 장기적인 발전소 운영 상태를 평가하는 데 유용한 지표임을 확인하였다. 그러나 이용률은 일사 조건과 계절 변화의 영향을 크게 받기 때문에 특정 고장이나 이상 상태를 단독으로 식별하기에는 한계가 있었다. 반면 PR은 일사량 대비 발전 성능을 평가할 수 있어 성능 저하에 민감하게 반응하였으나, 일사량 센서의 계측 오차, 데이터 동기화 문제, 센서 보정 상태 등에 따라 값이 크게 왜곡될 수 있음을 확인하였다. 특히 2025년 이후 PR이 급격히 저하되는 반면 이용률은 비교적 안정적으로 유지되는 구간이 관찰되었으며, 이는 설비 성능 저하보다는 기상센서 이상 또는 일사량 과대 계측에 따른 PR 과소평가 가능성을 시사한다. 비지도학습 모델 적용 결과, 이용률과 PR을 동시에 활용할 경우 단일 성능지표만으로는 구분하기 어려운 운전 패턴을 보다 효과적으로 분리할 수 있었다. i-Forest는 정상 운전 영역에서 이탈한 일부 이상 데이터를 탐지하는 데 유용하였으나, KPI 분포 특성에 따라 일부 저성능 구간을 정상으로 판단하는 한계도 나타났다. k-means는 이용률 중심의 군집화 경향을 보였으며, 운전 패턴의 전반적인 분포를 직관적으로 파악하는 데 활용 가능하였다. GMM은 PR 변화에 따른 군집 특성을 보다 효과적으로 반영하였으며, 정상 운전, 성능 저하, 저일사량 운전, 기상센서 이상 가능 구간을 구분하는 데 상대적으로 유용한 결과를 보였다.
본 연구의 결과는 저해상도 순시 데이터 기반 성능지표만으로도 태양광 발전소의 이상 운전 패턴을 1차적으로 감지할 수 있음을 보여준다. 특히 별도의 고장 라벨, I-V 측정 장비, 열화상 영상 또는 추가 센서 없이 기존 모니터링 시스템에서 산출 가능한 KPI를 활용했다는 점에서, 본 방법은 경제성과 현장 적용성이 높은 태양광 O&M 진단 방법으로 활용될 수 있다. 다만 KPI 기반 비지도학습 모델은 상세 고장 원인을 직접적으로 판별하기보다는 이상 가능성이 높은 운전 구간을 선별하는 사전 진단 도구로 활용하는 것이 적절하다.
향후 연구에서는 일사량, 모듈 온도, 인버터 출력, 스트링 전류, 알람 이력 등 추가 운전 데이터를 결합하여 이상 원인 분류 정확도를 향상시킬 필요가 있다. 또한 다양한 발전소와 장기간 운전 데이터를 대상으로 모델의 일반화 성능을 검증하고, 데이터 해상도 및 센서 품질이 KPI 기반 이상진단 성능에 미치는 영향을 정량적으로 분석한다면, 저해상도 모니터링 데이터 기반 태양광 O&M 기술의 신뢰성과 활용성을 더욱 높일 수 있을 것으로 판단된다.