

1. 서 론
2. 관련 연구
2.1 시계열 이상 탐지를 위한 순환 신경망과 어텐션
2.2 태양광 시스템 고장 및 이상 탐지
2.3 규칙 기반 약지도 라벨
2.4 이웃 상대 비교와 평가 분할 설계
3. 방법론
3.1 대상 데이터와 관측 단위
3.2 약지도 이상 상태의 정의
3.3 전처리와 입력 구성
3.4 모델 구조
3.5 평가 분할과 지표
4. 실험 결과
4.1 학습 설정
4.2 구조 탐색
4.3 교차검증
4.4 오류 분석
4.5 고전적 기계학습 모델과의 비교
5. 한계점
6. 결 론
1. 서 론
태양광 발전소의 모듈·스트링 단위 이상은 전체 발전량에 희석되어 상위 집계 지표에서 드러나지 않은 채 손실로 누적될 수 있다. 9 MWp 규모 발전소를 분석한 Buerhop et al. (2023)1)은 약 10%의 스트링이 저성능 상태임을 확인하였으며, 이는 판정 단위를 개별 설비까지 세분화할 필요성을 보여준다. 최근에는 모듈별 전류·전압·발전 전력·소자온도를 장기간 계측할 수 있어, 이러한 시계열로부터 이상 상태를 판정하는 딥러닝 접근이 가능해졌다.
그러나 실제 발전소에는 모듈별 이상 시점을 기록한 정비 이력이 충분하지 않아, 관측값에 임계값 규칙을 적용한 약지도 라벨이 주로 사용된다. 이 라벨은 외부 검사로 확정된 고장 정답과 다르며, 절대 온도 임계값을 사용하면 하절기에는 다수 모듈이 판정되고 동절기에는 판정이 감소하여 모델이 모듈 상태보다 계절·시간대에 의존할 수 있다. 또한 라벨 규칙과 관련된 동일 시점 관측값이 입력으로 제공되면 모델이 시간적 전개보다 손쉬운 규칙 단서를 학습할 수 있는데, 이는 Geirhos et al. (2020)2)이 설명한 지름길 학습(shortcut learning)에 해당한다. 따라서 약지도 라벨 분류 성능과 실제 고장 탐지 성능은 구분해 해석해야 한다.
본 연구는 이러한 문제를 완화하기 위해 동일 스트링 이웃 모듈 대비 상대 편차와 지속성 조건을 결합한 약지도 판정 기준을 구성한다. Leloux et al. (2020)3)과 Buerhop et al. (2023)1)은 각각 발전소 및 스트링 수준에서 상대 비교의 유효성을 보였고, Geirhos et al. (2020)2)과 Saeb et al. (2017)4)은 각각 지름길 학습과 개체 단위 누출의 위험을 지적하였다. 그러나 이러한 문제를 동일 스트링 내부의 모듈 수준 약지도 라벨, 모듈 분리 평가 및 모델 구성요소 분석으로 연결한 통합 절차는 충분히 다뤄지지 않았다. 따라서 본 연구의 목적은 새로운 단일 복합 모델을 제안하는 데 있지 않고, 계절 편향과 모듈 정체성 누출을 줄인 약지도 상태 분류 절차를 구축한 뒤 시계열 구조 요소의 실질적 기여를 평가하는 데 있다.
본 연구의 기여는 세 가지다. 첫째, 절대 온도 기준의 계절·모듈 편중을 실측 자료로 확인하고, 동일 스트링 이웃 상대 편차와 지속성 조건을 이용하여 Normal, LowPower, Thermal Anomaly의 3상태 약지도 라벨을 정의한다. 둘째, 동일 모듈의 정보가 학습과 시험에 함께 포함되는 누출을 방지하기 위해 모듈 단위 5-fold 교차검증을 적용하고, 동일 발전소와 관측 기간 내 미학습 모듈의 분류 성능을 평가한다. 셋째, 복합 모델 하나의 성능만 제시하는 대신 양방향성·Self-Attention·FFN·pooling의 16개 모델 구성을 완전요인 실험으로 비교하여, 각 구성요소의 기여와 구조 복잡도 증가의 실효성을 분석한다.
2. 관련 연구
2.1 시계열 이상 탐지를 위한 순환 신경망과 어텐션
Long Short-Term Memory (LSTM)는 Hochreiter and Schmidhuber (1997)5)가 장기 시점 간 의존성을 학습하기 위해 제안하였다. Self-Attention과 Multi-Head Attention은 Vaswani et al. (2017)6)이 Transformer 구조에서 체계화하였으며, 입력 시점 간 관계와 중요도를 직접 모델링할 수 있다. 양방향 LSTM은 Graves and Schmidhuber (2005)7)이 제안한 이후 과거와 미래 문맥을 함께 반영하는 방식으로 활용되었다. 시계열 상태 판정에서는 이러한 LSTM 계열 구조와 Attention을 결합하여 판정에 유효한 시간 구간을 강조하는 방식이 널리 사용된다.
태양광 분야에서도 Zhang et al. (2025)8)은 다중 스케일 합성곱, Multi-Head Attention, 양방향 LSTM과 Temporal Attention을 결합한 고장 분류 구조를 제안하였다. Wang et al. (2025)9)은 Spatial Attention과 시간 합성곱 신경망을 이용해 발전소 단위 진단을 수행하였고, Lodhi and Qiu (2026)10)는 클래스 불균형을 고려한 Attention 강화 분류기를 제시하였다.
다만 기존 연구는 여러 구성요소를 동시에 도입하는 경우가 많아 개별 요소의 기여를 분리하기 어렵다. 본 연구는 방향성, Self-Attention, FFN (Feed Forward Network), pooling의 16개 조합을 완전요인 설계로 비교하여 각 요소와 조합의 영향을 분석한다. 또한 극단적인 클래스 불균형에 대응하기 위해 Lin et al. (2017)11)의 focal loss와 가중 표본 추출을 함께 적용한다.
2.2 태양광 시스템 고장 및 이상 탐지
태양광 시스템의 고장 진단은 전기적·비전기적 고장을 포괄하며, 옥외 설치 구성품이 음영·오염·우박·낙뢰 등 환경 요인에 노출되어 발생하는 다양한 열화를 대상으로 한다. Nassreddine et al. (2025)12)은 기계학습 기법을 이용한 태양광 패널 고장 탐지·분류를 정리하였다.
과열은 전통적으로 열화상 기반 비접촉 검사로 진단되어 왔고, 정상 영역과 과열 셀 사이의 온도차가 수십 K에 이르는 사례가 보고된다. Ahmed (2026)13)는 열적 분석과 색채 분석을 결합해 확장 가능한 핫스팟 탐지 기법을 제안하였다. 본 연구는 열화상으로 확인된 셀 단위 핫스팟을 직접 진단하지 않으며, 옵티마이저 소자온도에서 관측되는 이웃 대비 상대 고온 상태를 Thermal Anomaly 약지도 클래스로 정의한다. 따라서 선행 연구의 물리적 핫스팟 개념은 상대 온도 기준을 설계하는 참고 근거이며, 본 연구의 평가 대상은 계측 기반 상태 라벨이다.
2.3 규칙 기반 약지도 라벨
고장 이력이 부재한 현장에서 학습용 라벨을 확보하는 일반적 방법은 관측값에 임계값 규칙을 적용하는 것이다. Severiano et al. (2026)14)는 인버터 데이터에 규칙 기반 판정을 적용해 저성능 상태를 탐지·분류하는 방법을 제시하여, 규칙 라벨이 태양광 분야의 실용적 대안임을 보여준다. 기계학습 일반에서 이는 데이터 프로그래밍 또는 약지도(weak supervision)로 정식화되어 있으며, Varma and Ré (2018)15)는 라벨링 함수를 자동 생성하는 절차를 제안하면서 규칙 라벨이 본질적으로 불완전하고 서로 상충할 수 있음을 전제로 삼았다. 본 연구도 생성된 상태를 외부 정비 정답이 아닌 규칙 기반 약지도 라벨로 다루고, 모델 성능을 해당 정의에 대한 분류 일관성으로 해석한다.
2.4 이웃 상대 비교와 평가 분할 설계
절대 임계값의 대안으로 동종 설비 간 상대 비교를 이용한 연구가 수행되어 왔다. Leloux et al. (2020)3)은 유사한 발전소를 비교하는 P2P (Performance to Peers) 지표를 통해 공통 기상 요인의 영향을 줄였으며, Alcañiz et al. (2022)16)는 동종 설비 기반의 감시·고장 탐지 절차를 체계화하였다. Buerhop et al. (2023)1)도 발전소 내부 스트링을 상대화하는 자기참조 방식이 저성능 스트링 식별에 유효함을 보였다. 본 연구는 이러한 상대 비교를 동일 스트링 내부의 모듈 단위로 확장한다.
평가 과정의 낙관적 편향도 중요한 문제다. Wu and Keogh (2022)17)은 시계열 이상 탐지 벤치마크의 부정확한 정답과 자명한 이상이 성능을 과대평가할 수 있음을 지적하였고, Kim et al. (2022)18)은 point-adjusted F1의 과대평가 가능성을 보였다. 또한 동일 개체의 기록이 학습과 시험에 함께 포함되면 모델이 이상 조건보다 개체 특성을 기억할 수 있다. Saeb et al. (2017)4)은 이러한 기록 단위 분할의 문제를 지적하였으며, 본 연구는 모듈 단위 5-fold 교차검증을 적용하여 학습과 시험 간 모듈 중복을 방지한다.
3. 방법론
3.1 대상 데이터와 관측 단위
본 연구는 4대의 인버터로 운영되는 태양광 발전소에서 15분 간격으로 수집한 모듈 단위 계측 자료를 사용한다. 각 관측은 출력 전류, 입력 전압, 출력 전압, 순간 발전 전력, 누적 발전량 및 소자온도로 구성되며, 자료 규모와 최종 out-of-fold 클래스 분포는 Table 1에 제시한다.
Table 1
Dataset composition, labeling conditions, and pooled out-of-fold class distribution
발전소는 인버터–스트링–모듈의 위계로 구성되며, 유사한 일사·기온 및 결선 조건을 공유하는 (인버터, 스트링) 조합을 이웃 비교 단위로 사용한다. 인버터와 스트링 식별자는 이웃 비교 그룹 구성에 사용하되, 별도의 인버터 운전 상태와 스트링 단위 전압·전류는 약지도 라벨 생성에 사용하지 않았다. 모듈 단위 출력 전류와 입력·출력 전압은 모델 입력 특징으로 활용하며, 입력 전압 1.0 V 미만 조건만 LowPower 판정에 포함한다. 06:00–19:45를 후보 시간 범위로 설정하고, 실제 판정은 3.2절의 유효 발전 조건을 만족하는 시점에서만 수행한다. 이웃 상대 편차는 공통 환경 영향을 줄이고 모듈별 상태 차이를 강조하기 위한 약지도 기준이며, 외부 고장 검증을 대체하지 않는다.
원자료는 부품 일련번호를 식별자로 사용하지만, 349개 설치 위치 중 318개에서 관측 기간 내 데이터베이스상 번호 변경이 확인되었다. 이에 설치 위치 식별자를 분석 단위로 사용하고 기준 시점의 인버터·스트링 배치를 전 기간에 적용하여 위치별 시계열을 복원하였다. 이는 식별자 변경에 따른 계열 분절을 줄이기 위한 처리이며, 물리적 교체 여부를 라벨로 사용하지 않는다.
3.2 약지도 이상 상태의 정의
본 연구는 Normal, LowPower, Thermal Anomaly의 세 상태를 규칙 기반 약지도 라벨로 정의한다. LowPower는 동일 스트링 이웃 모듈 대비 상대 저출력 상태를, Thermal Anomaly는 열화상으로 확인된 셀 단위 핫스팟이 아닌 이웃 대비 상대 고온 상태를 의미한다. 두 이상 상태 중 어느 것도 지속 조건을 충족하지 않으면 Normal로 정의한다.
판정은 주간 구간 중 해당 스트링의 중위 발전 전력이 5W를 초과하는 시점에서만 수행한다. 이웃 기준값은 동일한 (인버터, 스트링) 조합에 속한 모듈들의 동일 시각 중위값으로 계산하며, 극단값의 영향을 줄이기 위해 평균 대신 중위값을 사용한다. 판정에 사용하는 상대량은 다음과 같다.
•발전 전력비 = 해당 모듈의 발전 전력 ÷ (이웃 중위 발전 전력의 절댓값 + ε)
•온도 편차 = 해당 옵티마이저의 소자온도 − 이웃 중위 소자온도
발전 전력비가 0.50 미만이면 LowPower, 온도 편차가 5.0℃를 초과하면 Thermal Anomaly 후보로 판정한다. 입력 전압이 1.0 V 미만인 무전압 상태는 LowPower의 하위 유형에 포함한다. 각 조건이 연속 2개 표본에서 유지될 때 최종 상태로 확정하며, 인접 표본 간격이 20분을 초과하거나 야간·결측·분할 경계가 나타나면 지속성 카운트를 초기화한다. 모든 판정에는 현재와 과거 정보만 사용한다.
발전 전력비 0.50은 보편적인 고장 임계값이나 조기 고장 탐지를 위한 최적값이 아니라, 이웃 출력의 절반 미만으로 지속되는 명확한 상대 저출력을 보수적으로 구분하기 위한 약지도 기준이다. 이 기준의 통계적 위치를 확인하기 위해 기존 라벨로 선별하지 않은 fold 4의 유효 학습 관측 4,594,144개를 사후 분석하였다. 발전 전력비의 평균은 0.9981, 표준편차는 0.1052였으며, 현재 기준 0.50은 평균보다 4.74 표준편차 낮은 위치였다. 다만 전력비 분포가 비정규적이므로 평균−2표준편차를 임계값 선정 기준이나 실제 고장 확률로 해석하지 않았다.
발전 전력비 조건을 0.50에서 0.70으로 완화하면 연속 2표본 조건을 충족한 관측은 12,116개에서 14,312개로, 판정 대상 모듈은 60개에서 142개로 증가하였다. 이는 임계값을 높일수록 더 경미하고 넓은 범위의 출력 저하가 포함됨을 보여준다. 그러나 임계값 변경은 약지도 라벨 자체를 변화시키므로, 외부 정비 정답이 없는 본 자료에서는 임계값과 실제 고장 진단 정확도의 관계를 직접 평가하기 어렵다.
절대 온도 기준의 계절 편중을 확인하기 위해 소자온도 55℃를 비교용 기준으로 적용하였다. 이 값은 Thermal Anomaly의 판정 임계값이 아니다. 절대 55℃ 기준에서는 349개 중 347개 모듈이 관측 기간 중 한 번 이상 판정되고 1월·2월·12월에는 판정이 발생하지 않았다. 반면 이웃 중위 소자온도 대비 5.0℃ 초과 기준에서는 해당 월에 각각 1,351건, 2,184건, 537건이 관측되었으며, 판정 대상도 143개 모듈로 감소하였다. 이는 외부 고장을 확정하는 결과는 아니지만, 계절·시간대보다 동일 환경에 놓인 모듈 간 상대 상태에 초점을 맞춘 약지도 라벨을 제공한다.
지속성 적용 전 이상 구간의 중앙값은 15분 표본 1개로, 순간 음영이나 센서 잡음이 포함될 가능성이 있었다. 지속 조건을 4개 표본으로 높이면 LowPower 시험 모듈이 74개에서 8개로 감소한 반면, 2개 표본에서는 LowPower 74개와 Thermal Anomaly 102개 모듈을 유지할 수 있었다. 이에 연속 2개 표본을 순간 편차 제거와 평가 표본 확보 사이의 절충 조건으로 채택하였다.
두 이상 조건이 동시에 성립하면 운영 경보 등급에 따라 LowPower를 우선한다. 출력 전류와 입력·출력 전압은 모델 입력 특징으로 사용하였으나, 독립적인 운영 기준이나 검증 라벨이 확보되지 않았고 LowPower와 상태 범위가 중복될 수 있어 LowCurrent와 LowVoltage를 별도 클래스로 정의하지 않았다.
3.3 전처리와 입력 구성
모듈별 중복 시각 관측을 제거하고 시간순으로 정렬한 뒤, 계측값을 물리적으로 가능한 범위로 제한하였다. 발전 전력, 출력 전류, 소자온도에 대해서는 직전 16개 표본, 즉 4시간의 이동 평균과 이동 표준편차를 계산하며 미래 정보는 사용하지 않는다.
이웃 중위값은 데이터 분할 전에 계산한다. 분할 후 계산하면 동일 스트링의 이웃 집단이 축소되어 분할마다 라벨 기준이 달라질 수 있으므로, 전체 모듈 구성을 기준으로 라벨 정의를 고정하였다.
입력은 길이 48의 연속 윈도우로, 15분 간격 기준 12시간에 해당한다. 윈도우 마지막 시점의 라벨을 사용하므로 과제는 미래 예측이 아닌 현재 상태 분류이며 예측 지평은 0이다. 각 시점은 원계측값 6개, 이웃 중위값 4개, 이동 통계량 6개로 이루어진 16개 특징을 포함한다. 발전 전력비와 온도 편차는 라벨 생성에만 사용하고 입력에서는 제외하여 규칙을 직접 산술적으로 복제하는 경로를 제한하였다. 따라서 성능은 실제 고장 탐지율이 아니라 정의된 약지도 상태에 대한 분류 성능으로 해석한다. 윈도우 stride는 학습에서 4, 검증·시험에서 8로 설정하였다.
3.4 모델 구조
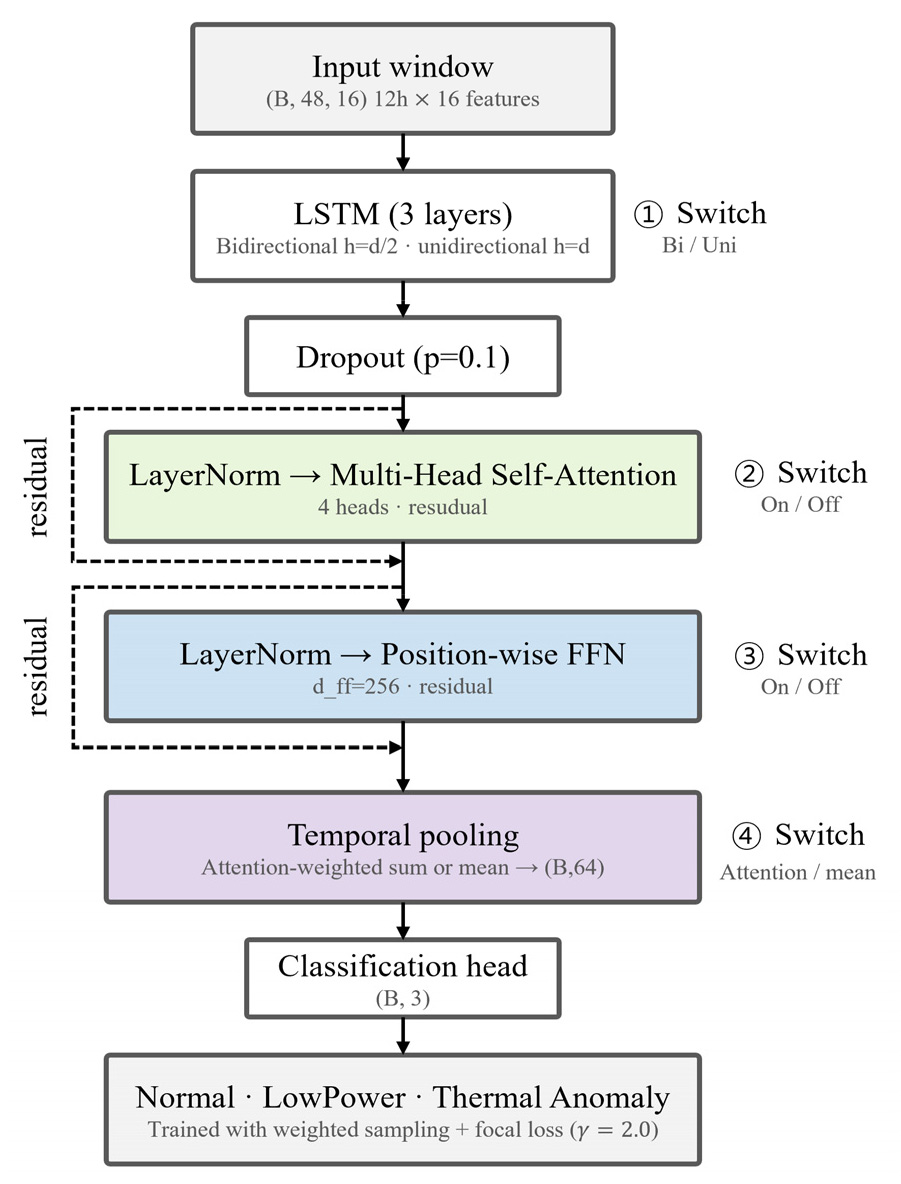
Fig. 1과 같이 방향성, Self-Attention, FFN, pooling의 네 요인을 각각 두 수준으로 조합할 수 있는 LSTM 기반 모델을 구현하였다. 방향성은 단방향 또는 양방향 LSTM, Self-Attention과 FFN은 사용 또는 미사용, pooling은 mean pooling 또는 Attention pooling으로 구성한다. 전방 경로는 다음과 같다.
•LSTM → dropout → Self-Attention block → FFN block → pooling → classification head
Self-Attention block과 FFN block에는 각각 LayerNorm과 residual connection을 적용하며, 사용하지 않는 block은 우회시키지 않고 생성 자체를 생략하여 파라미터 수에서 제외한다.
단방향 LSTM은 은닉 차원 전체를 사용하고, 양방향 LSTM은 방향별로 절반씩 배정하여 출력 폭을 동일하게 유지한다. 이에 따라 단방향 모델의 파라미터 수가 더 많을 수 있으므로, 방향성 효과와 모델 크기를 함께 확인할 수 있도록 각 구성의 파라미터 수를 보고한다. 모든 확장 요인을 적용한 구성의 출력 형상과 파라미터 수가 기준 구현과 일치하는지는 단위 시험으로 확인하였다.
3.5 평가 분할과 지표
동일 모듈의 윈도우가 학습과 시험에 함께 포함되면 모델이 상태 조건보다 모듈 고유 특성을 기억할 수 있으므로, 모듈 단위 5-fold 교차검증을 적용하였다. 각 모듈은 식별자와 고정 문자열을 결합한 SHA-256 해시로 fold에 배정하며, 학습·검증·시험 모듈 집합이 중복되지 않음을 확인하였다. 이 평가는 동일 발전소와 관측 기간 내에서 학습에 사용되지 않은 모듈에 대한 일반화 성능을 측정한다.
Fold를 회전시키는 이유는 이상 상태가 소수 모듈에 집중되어 단일 분할의 결과가 특정 모듈 배치에 크게 좌우될 수 있기 때문이다. 실제 단일 분할에서는 LowPower 시퀀스가 학습 1,853개, 검증 1,348개, 시험 72개로 편중되어 안정적인 시험 평가가 어려웠다.
정상 클래스가 압도적으로 많으므로 전체 정확도 대신 클래스별 F1과 Macro F1을 주 지표로 사용한다. 클래스별 정밀도·재현율과 OvR AUC를 함께 보고하며, 운영 관점에서는 LowPower와 Thermal Anomaly를 하나의 이상 클래스로 통합한 이진 정밀도·재현율·F1 및 오경보 수도 산출한다.
4. 실험 결과
4.1 학습 설정
정상 클래스의 비중이 압도적으로 높으므로 클래스 빈도의 역수를 이용한 weighted random sampling과 다중 클래스 focal loss (γ = 2.0)를 함께 적용하였다. 전체 실험의 공통 설정은 Table 2와 같다.
모든 모델은 동일한 학습 예산에서 비교하기 위해 100 epoch 동안 학습하고 조기 종료를 사용하지 않았으며, 검증 성능이 가장 높은 checkpoint를 선택하였다. 조기 종료는 수렴이 느린 구조에 불리할 수 있으며, 예비 실험에서도 구조 순위와 종료 epoch 사이에 0.874의 상관관계가 나타났다. 이후 실험은 Table 2의 설정을 공유하고 각 절에서 비교 요인만 변경하였다.
Table 2
Summary of experimental settings
4.2 구조 탐색
Table 3과 같이 방향성, Self-Attention, FFN, pooling을 각각 두 수준으로 설정한 16개 모델 구성을 고정된 모듈 단위 fold 4에서 세 개의 seed로 비교하였다.
기준 구성 c01 (단방향 LSTM, Self-Attention·FFN 미사용, mean pooling)만 뚜렷하게 낮았다. 최상위 구조보다 Macro F1이 0.0169 낮았고, LowPower F1도 0.9245로 다른 구조의 0.9534 ~ 0.9613보다 낮았으며, 최적 epoch도 38로 가장 빨랐다. 반면 Attention pooling (c02, +0.0153), Self-Attention (c05, +0.0149), 양방향성(c09, +0.0145), FFN(c03, +0.0138) 중 하나만 추가해도 성능 격차 대부분이 회복되었다. 이는 특정 요소의 절대적 우위보다 최소 구성에 표현 또는 pooling 기능을 보완하는 것이 중요함을 보여준다.
c01을 제외한 15개 구조의 Macro F1은 0.9792 ~ 0.9823으로 차이가 0.0031에 그쳤다. 구조 간 표준편차와 구조 내 seed 표준편차의 비율도 Macro F1 0.70, Thermal Anomaly 0.60, LowPower 0.74로 모두 1보다 작았으며, 주효과와 이차 교호작용의 절대 효과도 0.0017 ~ 0.0029로 유사했다. 파라미터 수는 약 두 배 차이였지만 성능과 일관된 관계를 보이지 않았다.
용량 증가 역시 일관된 이득으로 이어지지 않았다. 은닉 차원 64·2층이 Macro F1 0.9835로 가장 높았으나 기존 설정을 변경할 정도의 차이는 아니었다. 은닉 차원 128의 3·4층은 성능이 낮아지고 오경보가 최대 293건으로 증가했다. 반면 기준 파라미터의 31%인 은닉 차원 32·4층은 Macro F1 차이가 –0.0011에 불과하고 Thermal Anomaly는 +0.0052, 오경보는 74건으로 가장 적었으나 LowPower는 –0.0084 낮았다. Dropout을 0.2로 높인 경우에도 차이는 seed 산포보다 작았다.
이후 실험에는 양방향 LSTM, Self-Attention, FFN, Attention pooling을 포함한 c16 (은닉 차원 64, 3층, dropout 0.1)을 사용하였다. c16은 16개 구조 중 6위였지만 최상위와의 차이가 0.0007에 불과하고 두 이상 클래스에서 균형 잡힌 성능을 보였다. 계산 자원이 제한된 경우에는 c16의 61% 파라미터로 Macro F1 차이가 –0.0017인 c09를 경량 대안으로 사용할 수 있다.
Table 3
Comparison of 16 model configurations using the full-factorial design(module-level fold 4, 100 fixed epochs, three seeds). Macro F1 is reported as mean ± standard deviation; LP F1, TA F1, and best epoch are three-seed means. LP and TA denote LowPower and Thermal Anomaly. Test support: 205,926 Normal, 672 LowPower, and 4,222 Thermal Anomaly windows. Bold and underlined values indicate the best and second-best results, respectively.
4.3 교차검증
단일 fold에서 선정한 c16의 일반화 성능과 분할별 변동을 확인하기 위해 모듈 단위 5-fold 교차검증을 수행하였다(Table 4). 다섯 시험 집합을 합치면 349개 모듈이 각각 한 번씩 해당 모듈을 학습하지 않은 모델에 의해 평가되므로, 동일 발전소와 관측 기간 내 미학습 모듈에 대한 out-of-fold 성능을 나타낸다.
Table 4
Module-level 5-fold cross-validation and pooled out-of-fold evaluation
Thermal Anomaly F1의 fold 간 표준편차는 0.0027로 안정적이었지만, LowPower는 0.1132로 변동이 컸다. LowPower 지원이 28개와 45개인 fold 1·3에서는 F1이 각각 0.7879와 0.7273이었으나, 지원이 1,435개와 672개인 fold 2·4에서는 0.9829와 0.9601이었다. 이는 희소한 평가 표본과 fold별 모듈 구성이 LowPower 성능 변동에 함께 영향을 주었음을 보여준다. 전체 out-of-fold 지원 2,353개를 합산한 LowPower F1은 0.9655였다. Fold 평균은 모듈 집합에 따른 변동을, 합산 평가는 349개 모듈 전체의 윈도우 수준 성능을 나타내므로 두 결과를 함께 제시한다.
4.4 오류 분석
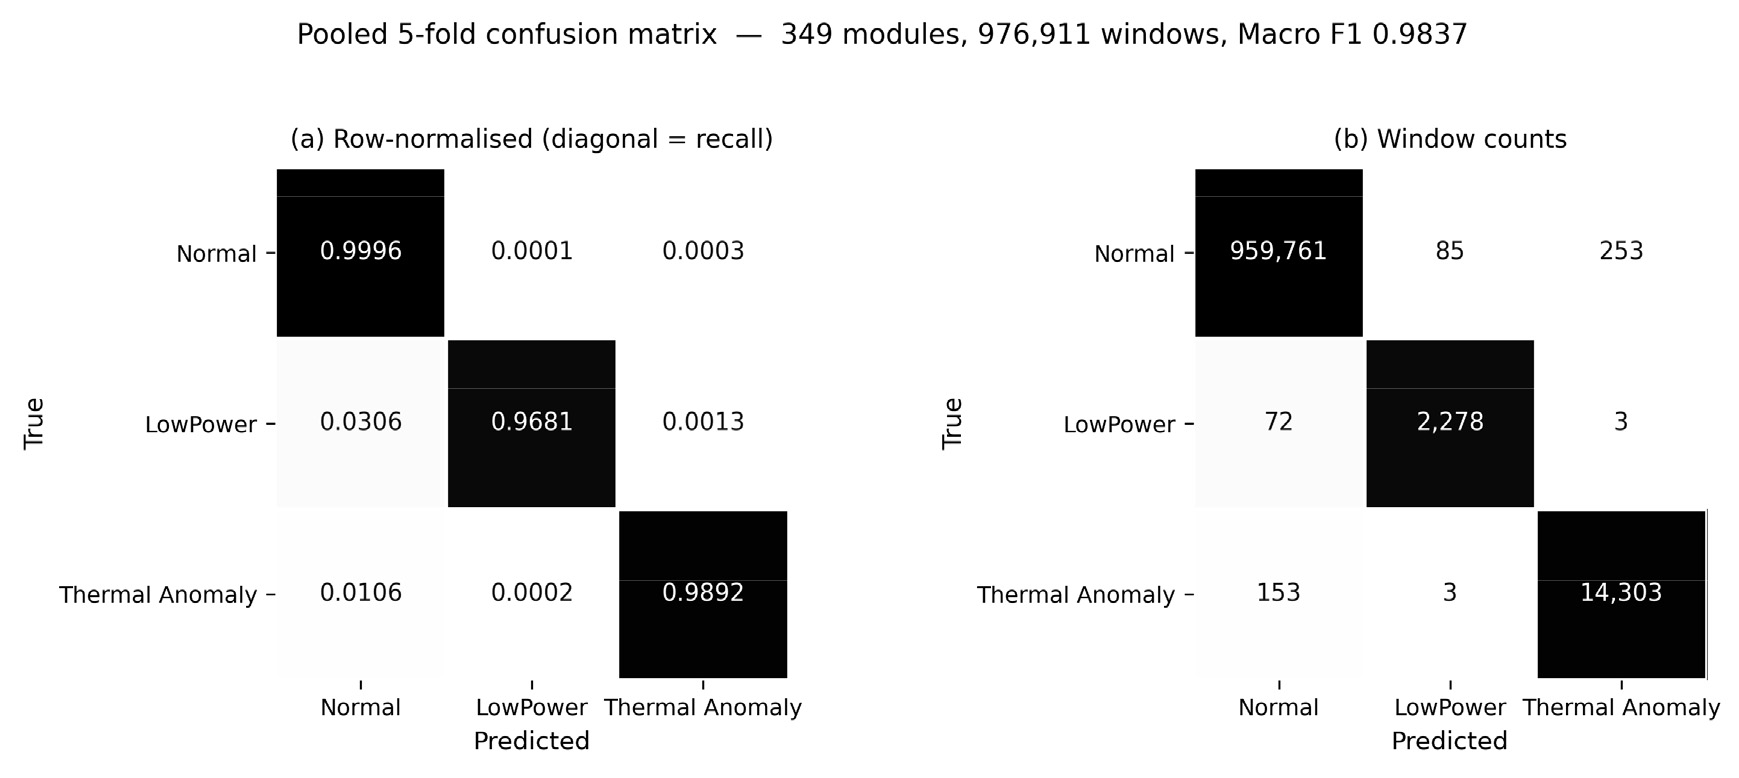
Fig. 2에는 합산 예측의 행 정규화 혼동행렬과 실제 윈도우 수를 함께 제시하였다. 정규화 값은 클래스별 오류 비율을, 원시 개수는 불균형 조건에서 실제 오경보와 미탐 규모를 보여준다.
본 연구에서 오경보(False Positive, FP)는 정답 라벨이 Normal인 윈도우를 LowPower 또는 Thermal Anomaly로 분류한 경우이며, 미탐(False Negative, FN)은 정답 라벨이 LowPower 또는 Thermal Anomaly인 윈도우를 Normal로 분류한 경우로 정의한다. LowPower와 Thermal Anomaly 사이의 상호 오분류는 이상 상태 자체를 놓친 경우가 아니므로 경보 유형 오류로 별도 구분하였다.
LowPower와 Thermal Anomaly 사이의 오분류는 각 방향 3건으로, 대부분의 오류는 정상과 이상 사이에서 발생하였다. 미탐은 LowPower가 Normal로 분류된 72건과 Thermal Anomaly가 Normal로 분류된 153건을 합한 225건으로, 전체 이상 윈도우 16,812건의 1.3%였다. 오경보는 Normal이 LowPower로 분류된 85건과 Thermal Anomaly로 분류된 253건을 합한 338건으로, 전체 정상 윈도우 960,099건의 0.035%였다. 정상/이상 이진 평가에서는 정밀도 0.9800, 재현율 0.9866, F1 0.9833을 기록하였다. LowPower의 미탐률은 3.1%로 Thermal Anomaly의 1.1%보다 높아 향후 개선이 필요한 주요 대상으로 확인되었다.
4.5 고전적 기계학습 모델과의 비교
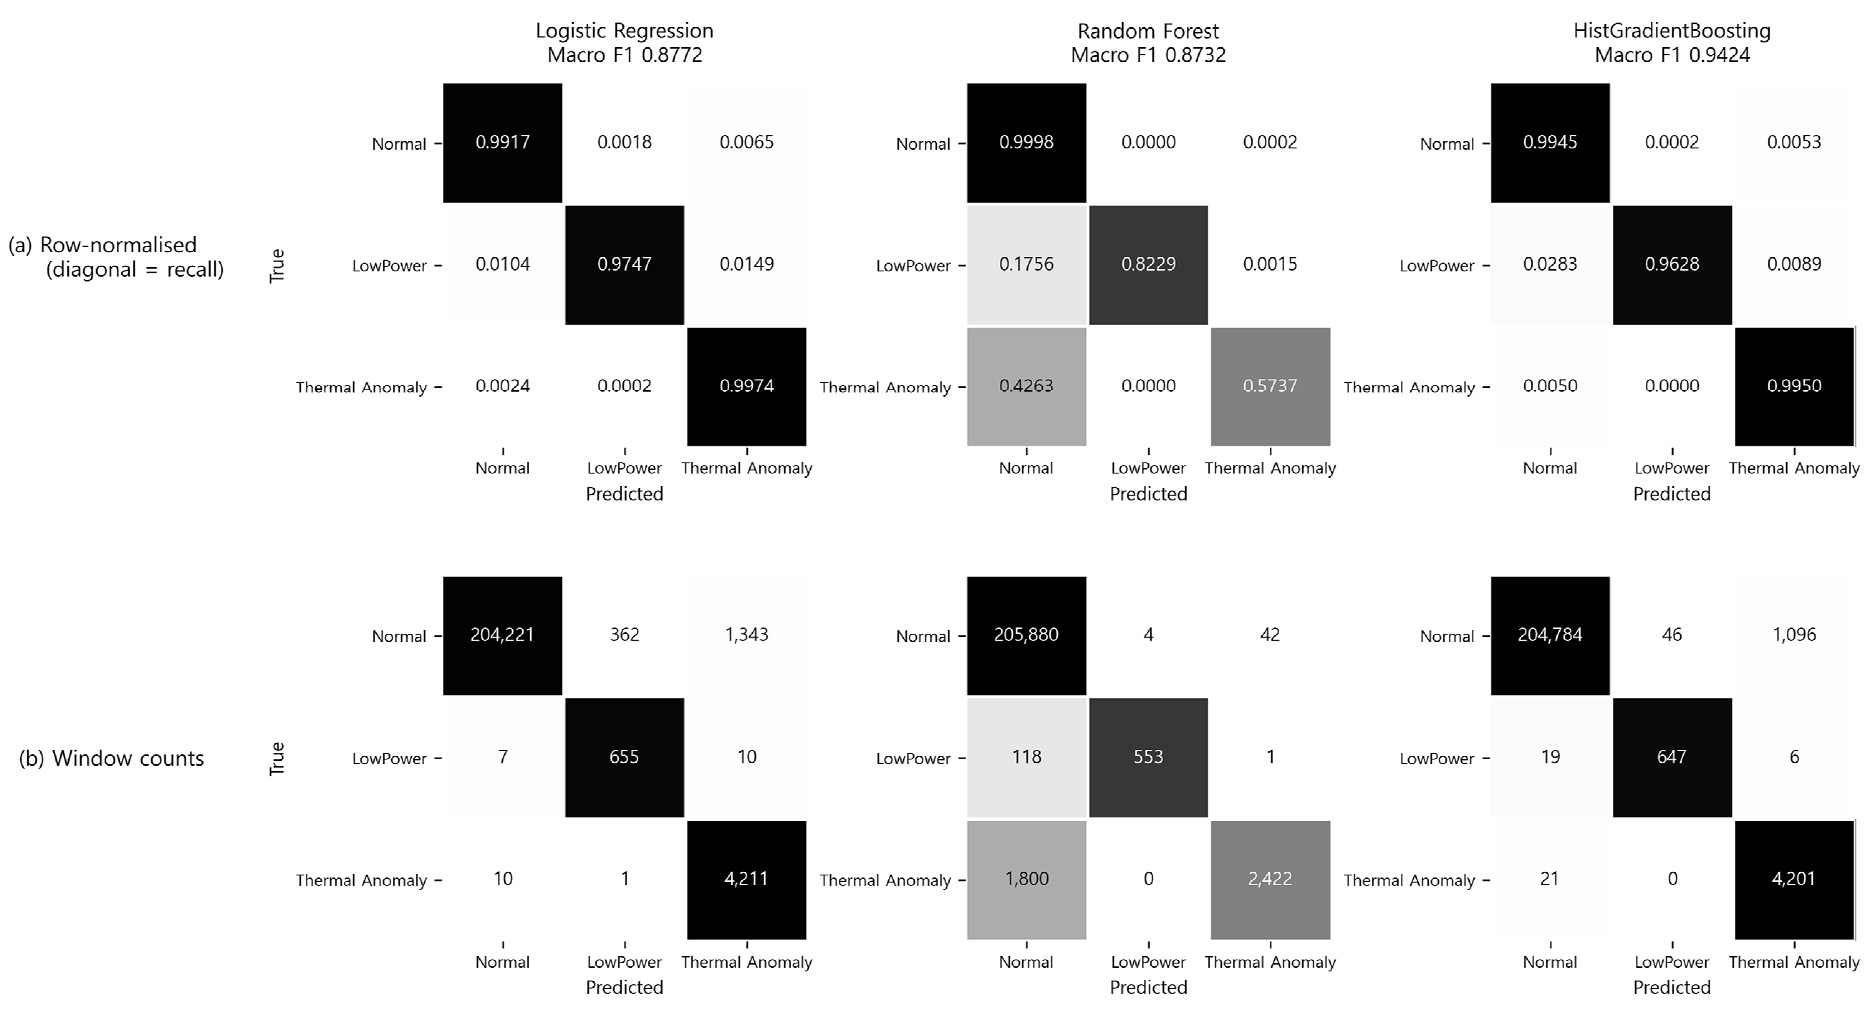
시계열 의존성 모델링의 효과를 확인하기 위해 Table 5와 같이 Logistic Regression, Random Forest, Histogram Gradient Boosting을 c16과 동일한 모듈 단위 fold 4에서 비교하였다. 고전적 모델에는 길이 48, 특징 16개의 윈도우를 768차원 벡터로 변환해 입력하였다. 시점별 값은 고정된 위치에 유지되지만 시점 간 의존성을 명시적으로 모델링하지 않는다. 분할·평가 시점·입력 정보는 c16과 동일하게 유지하고, 클래스 불균형에는 균형 클래스 가중치를 적용하였다.
Table 5
Comparison of c16 with classical machine-learning models in module-level fold 4 (210,820 test windows). Classical-model F1/AUC values use one fixed seed; c16 F1/AUC values are three-seed means, and error counts are window-level. Bold and underlined values indicate the best and second-best results, respectively.
Histogram Gradient Boosting은 고전적 모델 중 가장 높은 Macro F1 0.9424를 기록했으나, c16은 0.9816으로 0.0392 높았다. 이는 c01을 제외한 15개 딥러닝 구조의 성능 폭 0.0031보다 큰 차이로, 세부 구조 선택보다 시계열 의존성 모델링 여부가 성능에 더 큰 영향을 미쳤음을 보여준다.
오류에서도 c16이 가장 균형적이었다. Fig. 3에서 Logistic Regression은 Normal을 두 이상 상태 중 하나로 잘못 분류한 오경보 1,705건과 두 이상 상태를 Normal로 분류한 미탐 17건을 기록하였다. Random Forest는 오경보 46건과 미탐 1,918건을 기록하여 이상 상태를 Normal로 놓치는 경우가 많았으며, Histogram Gradient Boosting은 오경보 1,142건과 Thermal Anomaly F1 0.8821을 보였다. 반면 Table 5에서 c16은 오경보 191건과 미탐 31건을 함께 낮게 유지하면서 LowPower F1 0.9591과 Thermal Anomaly F1 0.9862를 기록하였다. Logistic Regression과 Histogram Gradient Boosting의 OvR AUC는 각각 0.9994와 0.9998로 c16의 0.9986보다 높았으나, AUC는 임계값과 무관한 순위 지표이므로 극단적 불균형에서는 클래스별 F1과 오류 건수를 함께 고려해야 한다.
5. 한계점
본 연구의 라벨은 외부 정비 이력이나 열화상 검사로 확정된 실제 고장 정답이 아니라 이웃 상대 기준으로 생성한 규칙 기반 약지도 라벨이다. 또한 구조 비교는 단일 fold에서 수행되었고, 평가는 동일 발전소와 관측 기간의 중첩 윈도우 단위이므로 다른 기간·발전소 및 독립적인 경보 사건에 대한 일반화에는 제한이 있다. 향후 외부 점검 자료와 독립 발전소 데이터를 이용한 검증이 필요하다.
6. 결 론
본 연구는 349개 태양광 모듈의 15개월 관측 자료 8,036,162행을 이용하여, 동일 스트링 내 이웃 상대 기준과 연속 2표본 지속 조건을 결합한 3상태 약지도 분류 절차를 제안하였다. 계절 민감도 비교를 위해 적용한 절대 55℃ 기준에서는 349개 중 347개 모듈이 관측 기간 중 한 번 이상 판정되었다. 반면 Thermal Anomaly를 해당 옵티마이저의 소자온도가 동일 스트링 이웃 중위 소자온도보다 5.0℃를 초과하고, 이 조건이 연속 2개 표본에서 유지되는 상태로 정의한 결과 판정 대상이 143개 모듈로 좁혀져 절대 기준의 계절·모듈 편중이 완화되었다. 모듈 단위 5-fold 교차검증에서 Macro F1은 0.9544 ± 0.0373이었으며, 976,911개 out-of-fold 윈도우를 합산한 결과 Macro F1 0.9837과 정상/이상 이진 F1 0.9833을 기록하여 미학습 모듈에 대한 분류 가능성을 확인하였다.
16개 모델 구성 비교에서는 단방향 LSTM과 mean pooling만 사용한 기준 구성이 뚜렷하게 낮았으며, 양방향성·Self-Attention·FFN·Attention pooling 중 하나만 추가해도 성능이 대부분 회복되었다. 상위 구조 간 차이는 작아 운용 조건에 따라 표준 또는 경량 구조를 선택할 수 있었다. 또한 c16은 가장 우수한 고전적 기계학습 모델보다 Macro F1이 0.0392 높고 오경보와 미탐도 함께 낮아 시계열 의존성 모델링의 효과를 보였다. 이러한 결과는 약지도 라벨 설계와 모듈 단위 누출 방지, 모델 구조 비교를 통합한 실용적인 태양광 모듈 상태 분류 절차를 제시한다.